
Entrenando modelos de decisión: caso práctico con Laya
05-10-2026
Un dado muy caro
Julia dejó el bloc encima de la mesa de la sala de control con bastante más fuerza de la necesaria.
—¡Un mísero veintiséis por ciento! —dijo.
—¿Cómo? —le pregunté sobresaltado.
—Que le he pasado trescientas situaciones del parking —suspiró —, y sólo acierta un veintiséis por ciento de los casos.
Ese era el porcentaje de veces que nuestro cerebro de zombi, el que montamos con Laya hace unos días, acertaba qué iba a hacer el infectado: atacar, seguir, ignorar o vagar. Y eso con solo cuatro opciones. Tirando un dado de cuatro caras habríamos sacado un 25%. Vamos, que teníamos un dado virtual que ocupaba 650 MB y encima tardaba un rato en arrancar.
Tampoco nos pilló del todo por sorpresa, porque la propia model card avisa de que Laya es una base de la que partir para luego especializar y no el oráculo de Delfos listo para descargar y usar (ya lo comenté en el artículo anterior). La duda con la que nos quedamos era si especializarla estaba a nuestro alcance con lo que había en el refugio: un viejo sobremesa con un i5 de novena generación, 16 GB de RAM y una modesta nVidia GTX 1660 de 6 GB.
Por suerte, tras varios intentos descubrimos que la respuesta era que sí, y aún nos sobraba un poco de potencia para jugar a Skyrim mientras tanto (tampoco os penséis que es una 5090).
Lo primero que hicimos fue separar lo que nos estaba pasando en dos problemas. Por un lado el modelo de base elige mal, y por otro, cuando elige mal lo hace lleno de orgullo y satisfacción. Esto último se puede arreglar sin tocar el modelo, con algo que se llama calibración. Pero para lo primero no queda otra que entrenarlo, y ahí usamos LoRA, una técnica que permite entrenar un modelo sin tener que reentrenarlo entero (lo sé, parece un trabalenguas), porque el entrenamiento completo no cabía en nuestra tarjeta. Vamos primero con el entrenamiento, que es lo que más falta nos hacía.
Todo el código está en la carpeta entrenamiento/ del Refugio de Laya, el mismo repositorio del artículo anterior.
De dónde sacar los datos
Tanto para calibrar como para entrenar necesitas situaciones de las que ya conozcas la respuesta. La otra vez Julia y yo etiquetamos unas 150 a mano y acabamos un poco hartos, así que para entrenar, que pide bastantes más, había que buscar otra forma.
Julia, que ya tenía su bloc de notas lleno de observaciones, se limitó a escribir las reglas que había ido sacando. Si el olor humano es intenso y la presa está a menos de diez metros, el zombi ataca. Si hay rastro humano pero lejos o flojo, lo sigue. Si solo hay ruido, lo ignora, y si no hay nada, vaga por ahí. Para la puerta norte hizo lo mismo: a quien tenga una mordedura o gruña no se le abre; a quien hable con normalidad pero tenga heridas que no sabe explicar, a cuarentena; y el resto pueden entrar.
Con esas reglas, generar_datos.py hace las cosas al revés de lo que parecería lógico. Primero elige la respuesta correcta y después escribe una situación que encaje con ella, sacando las frases de unas listas:
{
  "state": {
    "ruido": "una botella rueda por la acera a unos 10 metros, cerca de la rampa",
    "olor": "sudor de miedo, fresco y fuerte",
    "luz": "farolas rotas, casi a oscuras",
    "distancia_presa": "pegado al coche, a 2 metros"
  },
  "questions": { "...": "las mismas del ejemplo del parking" },
  "respuestas": { "accion": "atacar", "hambre": 2, "humano_cerca": true }
}
Las listas de frases están partidas en dos mitades, una para entrenar y otra para examinar. Y esta separación es muy importante, ya que si examinas al modelo con las mismas frases con las que ha entrenado, seguramente haga todo perfecto porque se ha aprendido que «sudor de miedo, fresco y fuerte» siempre acaba en «atacar», sin haber entendido nada de lo que significa.
Con las frases de entrenar salen 1.100 situaciones: 800 para que el modelo aprenda y 300 para ir comprobando, mientras entrena, que va por buen camino. Con las de examinar, que el modelo no ve durante el entrenamiento, salen otras 600: 300 para calibrarlo y 300 para la prueba final. Y aparte guardamos las seis situaciones de la terminal del artículo anterior, etiquetadas a mano, para ver al final con nuestros propios ojos si el caso del zombi con la lata y el caso de la niña que tiene un arañazo han mejorado.
Unos datos generados a partir de reglas tienen su trampa, ya que el modelo sólo termina aprendiendo tus reglas y no lo que hay en el mundo real. Si las reglas están mal, aprenderá a equivocarse y a esa equivocación responderá con mucha seguridad. En un refugio de verdad yo mezclaría estas situaciones con casos reales etiquetados a mano, y la prueba final la haría solo con casos reales.
LoRA, entrenar sin desmontar el modelo
Qué es entrenar
Un modelo como Laya es, en el fondo, una cantidad enorme de números. En el multilingüe son 322 millones, y se les llama pesos o parámetros. Cuando le pasas una situación el texto se convierte en números, se multiplica y se suma con esos pesos una y otra vez, y al final sale una puntuación para cada opción. Si cambias los pesos, cambian las puntuaciones, y con ellas la respuesta.
Puedes imaginarlos como la típica consola de una nave de Star Wars llena de controles y mandos. Entrenar consiste en ir girando esos mandos poco a poco hasta que suene bien. El proceso, simplificado, es este:
- Le pasas al modelo una situación de la que conoces la respuesta, por ejemplo una en la que el zombi debería atacar.
- El modelo responde, pongamos que con un 30% para «atacar».
- Se mide cuánto se ha equivocado. A ese número se le llama pérdida: cuanto más alto, peor. Si hubiera dicho «atacar» con un 100%, la pérdida sería cero.
- Se calcula hacia dónde habría que girar cada mando para que la próxima vez la pérdida fuera un poco menor, y se gira cada uno un poquito en esa dirección.
Todo lo anterior se repite miles de veces. Aunque para no ir de una en una, las situaciones se pasan en pequeños grupos llamados lotes (en el código que hemos usado, de ocho en ocho), y a cada vuelta completa por todas las situaciones de entrenamiento se le llama época.
Si te suena, es porque es lo mismo que hacíamos en JavaScript con una sola neurona para que aprendiera como funciona la operación AND, y luego con una red pequeña. Laya funciona igual, solo que tiene unos cuantos millones de parámetros más.
Y qué es el fine-tuning
Laya nos llegó ya entrenado para entender el idioma. A eso se le llama preentrenamiento, necesita de gráficas potentes y una cantidad enorme de texto durante mucho tiempo. Lo que viene después es coger ese modelo y adaptarlo a lo que necesitas con tus datos, y como ya tiene una base no son necesarios tantos recursos. A nosotros nos bastaron unos cientos de ejemplos y unos minutillos. A eso le llamamos fine-tuning (en español sería ajuste fino, pero creo que nadie lo llama así).
La idea de LoRA
El cuaderno oficial de Laya hace ese fine-tuning con el modelo entero, o sea, gira los 322 millones de mandos, y para eso usa dos tarjetas T4 de Kaggle. Las necesita, porque para girar un mando hay que guardar varios números además de su valor, y solo con eso se van más de 5 GB antes de haberle pasado una sola situación. En los 6 GB de nuestra GTX 1660 entra tan justo que no quedaría sitio para trabajar.
LoRA, siglas de Low-Rank Adaptation (lo de low-rank lo explico enseguida, ansias), es otra forma de hacer fine-tuning. La idea es no tocar ni uno solo de los 322 millones de parámetros y, en lugar de eso, añadir unos pocos nuevos que corrijan lo que hace falta.
En el refugio teníamos un manual de supervivencia que alguien imprimió antes de que se fuera la luz, con capítulos enteros que ya no servían de mucho. Reescribirlo era impensable, así que la gente fue pegando pósits en los márgenes: «no hace falta hervir el agua diez minutos, con cinco minutos sobra y ahorras leña», o «este atajo está bloqueado desde el 4 de octubre de 2026». El manual seguía siendo el mismo, pero quien lo leía con los pósits hacía las cosas mejor siguiendo estas indicaciones específicas tras nuestra experiencia sobreviviendo en el refugio. LoRA hace lo mismo con el modelo, que se queda congelado mientras se entrenan solo esas anotaciones.
Esos pósits no van en cualquier sitio. Por dentro, el modelo está hecho de capas, y muchas de ellas son una tabla grande de números (una matriz) por la que pasan los datos y salen transformados. Junto a cada una de esas tablas, LoRA añade un pequeño desvío formado por dos tablas muy estrechas, que en el código se llaman A y B. Lo que sale de la capa pasa a ser lo de siempre más lo que aporte el desvío, y al entrenar solo se giran los mandos de A y B.
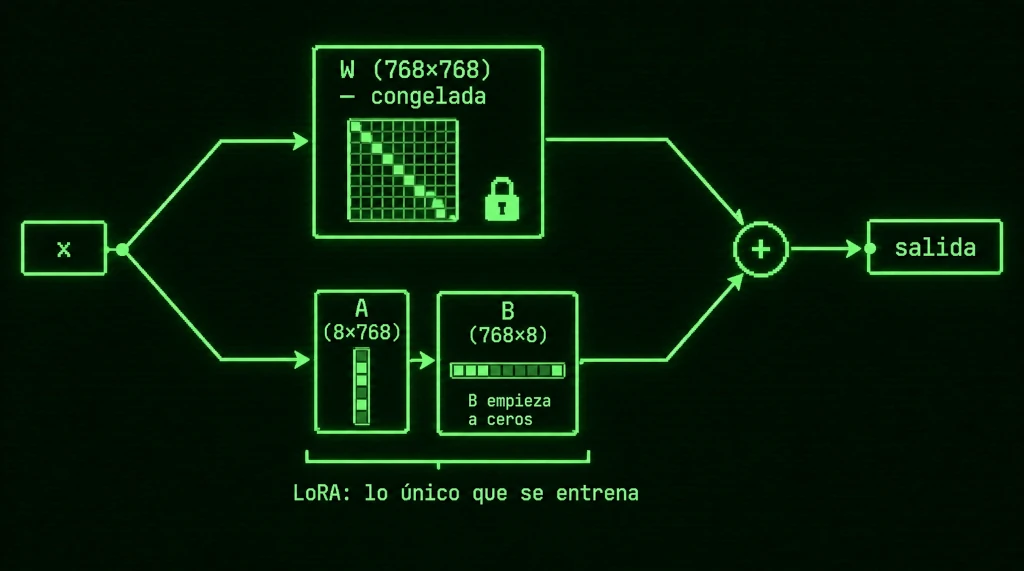
Una de las capas de Laya es una tabla de 768 × 768, casi 590.000 números. Con LoRA, A y B tienen 8 filas o columnas en lugar de 768, y entre las dos suman 12.288 valores. Ese 8 es el rango (el rank de low-rank) y viene a ser cuánto se puede escribir en cada pósit. Con un rango más grande caben correcciones más detalladas, pero también hay más parámetros que ajustar. En nuestro caso, sumando todas las capas se entrenan 1,7 millones de parámetros en vez de 322, así que la memoria deja de ser un problema.
La tabla B comienza con todo lleno de ceros. O lo que es lo mismo, al principio el desvío no aporta nada de nada y el modelo es el original. Volviendo a nuestro símil, se pegan pósits en blanco y el entrenamiento solo tiene que aprender qué escribir en ellos.
Además, la ventaja de esto es que como los pósits ocupan poquísimo, podrías tener un juego para la puerta norte y otro para el parking. De forma que podrías ir cambiándolos sobre el mismo modelo según el caso que necesites.
Si te pica la curiosidad puedes ver como escribimos el código de esta parte, está en lora.py. El script pone uno de estos desvíos en 88 capas de la parte de Laya que lee y entiende el texto, y la parte final encargada de tomar la decisiones la deja como está.
Mientras entrena, el script también baraja el orden de las opciones de las preguntas choice cada vez que pasa por una situación. Si «atacar» unas veces aparece la primera y otras la tercera, el modelo no puede aprender a fijarse en la posición para elegir. Con esto intentamos quitarnos de encima el problema que podía ver en el artículo anterior con Albacete y Puertollano.
Entrenando
Para este artículo añadí la repo de la terminal del refugio una sección de entrenamiento (> entrenar() en el menú). Desde ahí puedes lanzarla y ver el progreso de forma más bonita, algo mucho mejor que mirar una triste consola (vale, la web parece una consola touché). Esto es lo que quedó en pantalla al terminar:
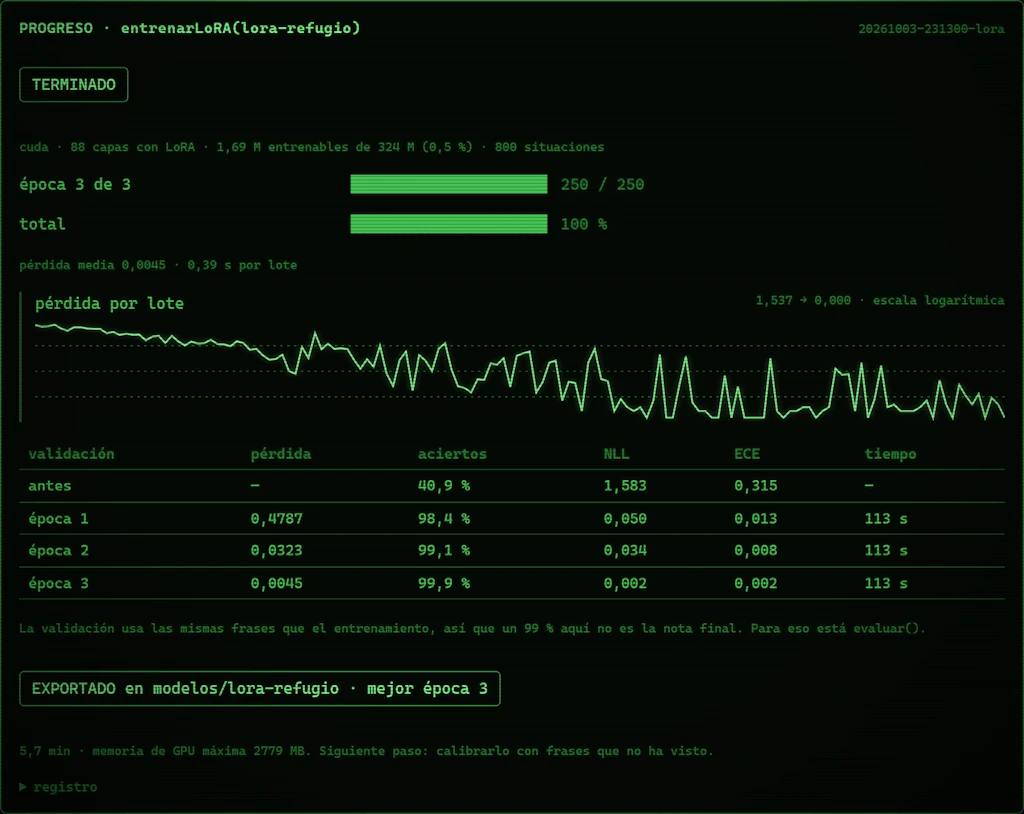
Julia se asomó a mitad del entrenamiento y preguntó si esa línea que bajaba a trompicones era buena señal. Y aunque se vea rara, lo es. Es la curva de la pérdida, aquel número que medía cuánto se equivoca el modelo, dibujado lote a lote, y si el entrenamiento funciona tiene que ir bajando. Los trompicones son normales, porque cada lote trae situaciones distintas y unas cuestan más que otras.
Las tres épocas llevaron 5,7 minutos y no pasaron de 2,8 GB de los 6 que tiene la tarjeta, y eso con la terminal ocupando su parte con el cerebro cargado.
Al final de cada época el script le pone un examen con las 300 situaciones que usamos para validar, y en el último saca un 99,9%. Aquí debemos pensar una cosilla, queda muy bien en pantalla, pero ese examen usa las mismas frases del entrenamiento, así que de momento solo sabemos que se las ha aprendido.
Al terminar, el script pasa los pósits a limpio y deja en modelos/lora-refugio/ un Laya ya entrenado, pero normal y corriente por fuera: se carga igual que el que se descarga de Hugging Face.
El examen de verdad
Tras el entrenamiento, llegó el momento de pasarle las 300 situaciones de prueba:
| Aciertos | Seguridad media | Cambia con el orden | |
|---|---|---|---|
| Laya tal cual | 44,8% | 72,2% | 40,3% |
| LoRA | 82,4% | 97,2% | 14,7% |
En aciertos pasamos del 44,8% al 82,4% con frases que nunca había visto. Está muy bien, aunque queda lejos de aquel 99,9% de la validación. A esa diferencia entre ambas se le llama sobreajuste. El modelo se aprende tan bien lo que ha visto que, en cuanto le cambias las palabras, se queda a medias (ya lo vimos en el artículo de la neurona, al entrenar de más).
El sobreajuste solo se pilla examinando al modelo con algo que no haya visto nunca. Si entrenas algo tuyo, guarda una parte de los datos bajo llave, que el modelo no la vea, y no la toques hasta el final.
El 44,8% del modelo original, por cierto, no contradice el 26% del bloc de Julia. Ella solo miraba qué hace el zombi, y en la tabla entran todas las preguntas. Por preguntas, la de si hay un humano cerca llega al 96% y la del hambre al 87%. Donde más le cuesta es en la decisión de la puerta norte, que se queda en un 57%.
Lo de barajar las opciones también se nota. La última columna cuenta las preguntas choice en las que la respuesta cambia al darle la vuelta al orden, y el modelo original cambiaba de opinión en ocho de cada veinte, y ahora solo en tres.
Los fallos de la puerta se parecen mucho entre sí. De las 59 personas que debían ir a cuarentena, 35 acabaron rechazadas. Alguien con sangre en la manga que no explica, una venda que no quiere enseñar... Con las frases que conocía distinguía bien un caso del otro, pero con las nuevas, cuando duda, prefiere no arriesgarse.
Con la seguridad media, que es lo seguro que dice estar el modelo de sus respuestas, seguimos teniendo un problema, ya que dice un 97% per sólo acierta un 82%. ¿Se puede mejorar eso? Sí gracias a la calibración.
Calibrando la situación
Entrenar ha arreglado el primer problema, pero el segundo (la false seguridad del modelo) sigue ahí. Si vamos a dejar que el modelo decida solo cuando esté muy seguro, necesitamos que «muy seguro» sea de verdad lo que significa.
Por dentro, Laya no piensa directamente en porcentajes. Primero le pone una nota a cada opción y después convierte esas notas en probabilidades. Justo antes de esa conversión, divide todas las notas por un mismo número, al que se llama temperatura.
Con temperatura 1 no cambia nada. Si la subimos, las notas se acercan entre sí y el modelo se vuelve más prudente: donde antes decía un 95%, ahora dice, pongamos, un 80%. Si la bajamos, pasa lo contrario y se vuelve más tajante.
Lo bueno es que la opción ganadora sigue siendo la misma, porque si divides todas las notas por el mismo número, la más alta lo sigue siendo. Las respuestas no cambian, solo lo seguro que dice estar de ellas. Calibrar es buscar la temperatura con la que, cuando el modelo diga «90%», acierte de verdad nueve de cada diez veces.
Con el manual de los pósits sería como no tocar el texto y apuntar en la primera página algo como «aquí el autor exagera; donde pone seguro, entiende probablemente». Lo que dice el manual sigue siendo lo mismo, pero ahora sabes cuánto fiarte. Calibrar no gira ni un solo mando, y por eso cuesta tan poco.
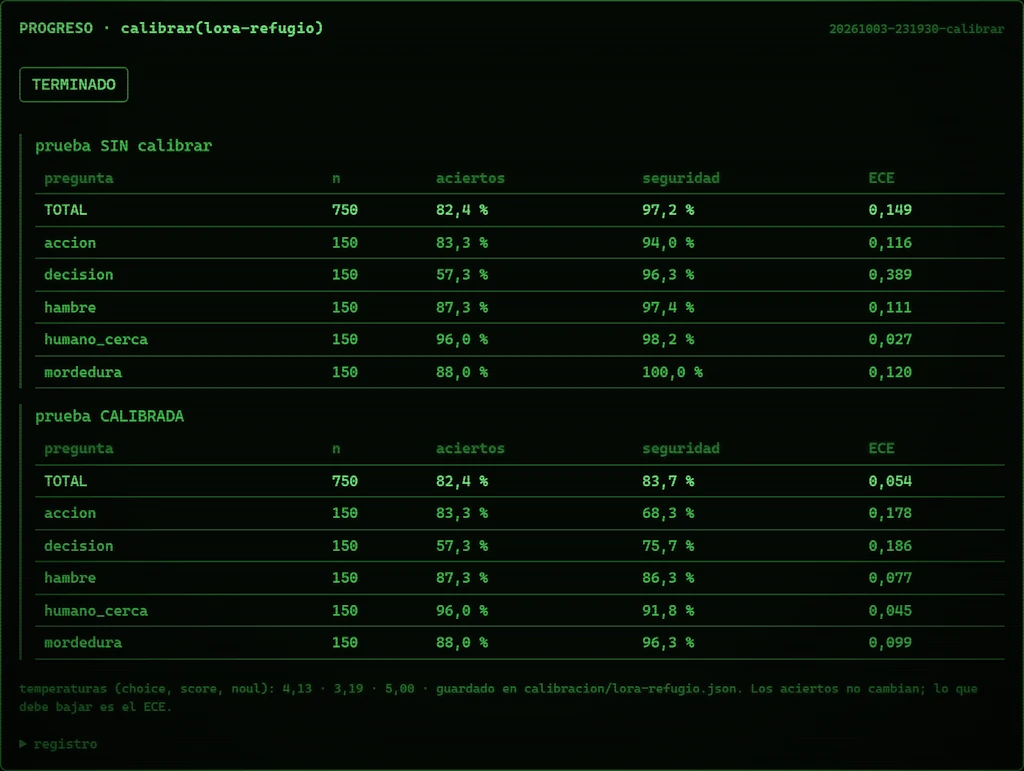
Laya ya viene preparado para esto, porque cada modelo guarda en su fichero rl_agent_config.json una temperatura por tipo de pregunta. De fábrica están todas a 1, o sea, sin calibrar. calibrar.py pasa las situaciones de calibración por el modelo, va probando temperaturas y se queda con la que deja la pérdida más baja, porque la pérdida castiga sobre todo los errores cometidos con mucha seguridad. Esto en CPU sólo lleva unos minutillos:
python -m entrenamiento.calibrar --modelo modelos/lora-refugio
| Aciertos | Seguridad media | |
|---|---|---|
| Laya tal cual | 44,8% | 72,2% |
| Laya calibrado | 44,8% | 50,7% |
| LoRA | 82,4% | 97,2% |
| LoRA calibrada | 82,4% | 83,7% |
Puedes ver como los aciertos no se mueven ni una décima. Pero lo que sí ha cambiado es la seguridad, que en la LoRA pasó del 97,2% al 83,7%, muy cerca del 82,4% que acierta de verdad.
También a modo de curiosidad calibré el modelo original para ver qué resultados daba. Recuerda que hay una temperatura por cada tipo de pregunta, y en casi todas salió un 5, el valor más alto que admite Laya. Es la forma que tiene la calibración de decirnos que el modelo presume de mucha más seguridad de la que merece. Tanto, que el 5 se le queda corto: si Laya dejara pasar de ahí, habría seguido subiendo.
El día que calibré con lo que no tocaba
Antes de llegar a esos números metí la pata, y es que la primera vez que entrené la LoRA, la calibré con situaciones escritas con las frases de entrenamiento. Como el modelo las acertaba casi todas, la calibración sacó la conclusión que le pedían los datos, que el modelo era demasiado prudente y podía permitirse estar todavía más seguro. Bajó la temperatura a 0,5, el mínimo que admite Laya, así que al probar frases nuevas el modelo salió peor calibrado que si no hubiera hecho nada.
En la segunda vuelta la calibré con frases de la segunda mitad, las que no había visto al entrenar y que se parecen más a lo que se va a encontrar luego en el mundo real. Eso sí, en situaciones distintas de las de la prueba, ya que si no sería hacer trampa.
El cerebro nuevo, de guardia
Cuándo decide solo
¿Y cuál es la gracia de tener una seguridad de la que te puedes fiar? Pues que puedes poner un umbral. Si el modelo pasa del 85%, dejas que decida por su cuenta, y si no, puedes tomar el control para tomar la decisión, ya sea con revisión humana, llevar el código por otro flujo, etc. Si nos vamos a los fríos datos, con ese umbral, la LoRA calibrada decide sola en el 58% de los casos y en esos acierta el 90%.
Para comparar, el Laya original, también calibrado, solo pasaba de ese 85% en el 3% de los casos. Esos los acertaba casi todos, la verdad, pero de poco sirve un vigilante que en 97 de cada 100 casos te hace bajar a la puerta. Nuestro Laya entrenado con LoRA, en cambio, se apaña solo en más de la mitad. Así que Julia, que es quien más guardias hace, fue la primera que estaba dando saltos de alegría por el trabajo que le ahorraba.
Los ejemplos del artículo anterior
Entre las seis situaciones de la terminal suman 14 respuestas. De esas, el modelo original acertaba 10 y con LoRA acierta 13, y entre ellas están las dos que más me fastidiaban. El zombi del parking por fin deja de oler humanos que no existen (dice que no hay olor humano con un 97%). Y la niña que tenía un arañazo, que antes entraba por la puerta con un 97% de seguridad, ahora va a cuarentena con un 70%. Julia approves.
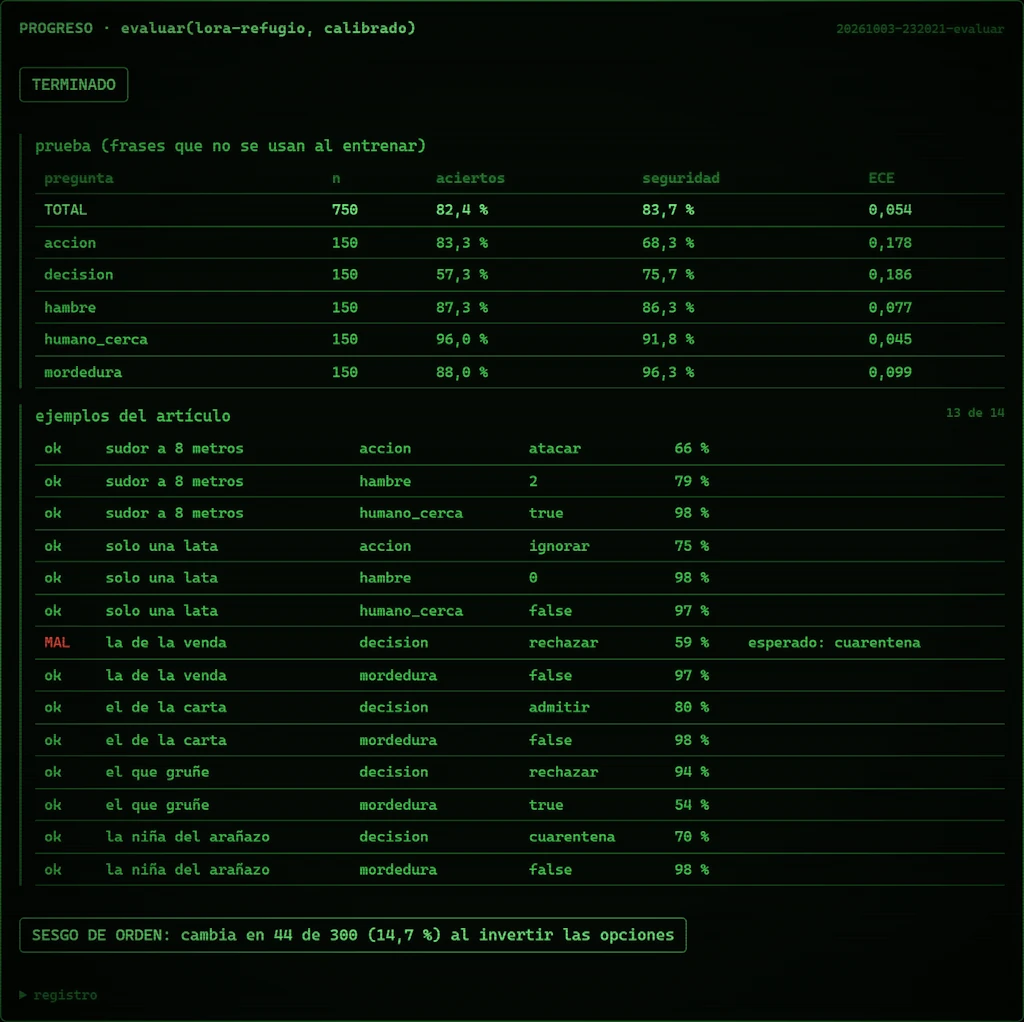
Pero aún hay casos que no van del todo bien, por ejemplo: la mujer de la venda con sangre seca debería ir a cuarentena, pero acaba rechazada. Es el mismo fallo de antes, aunque al menos lo hace con menos seguridad (un 59%), y con cualquier umbral sensato bajaría alguien de guardia a hablar con ella. Al hombre que gruñe sí lo rechaza, con un 94%, pero a la pregunta de si tiene una mordedura contesta que sí con un 54% raspado, aunque el estado pone «marca de dientes en el cuello». La culpa de eso es mía, porque al preparar las listas quité esa frase a propósito, para no colar el texto del artículo en el entrenamiento, y en las que quedaron había mordiscos y dentelladas, pero ninguna «marca de dientes».
Entrené esta LoRA dos veces, con los mismos datos y la misma semilla, y no salieron dos cerebros idénticos. Los dos aciertan el 82,4% de la prueba, pero en los ejemplos del artículo el primero fallaba la mordedura del que gruñe y el segundo falla la decisión de la mujer de la venda. En una GPU, algunas operaciones no dan exactamente el mismo resultado de una vez a otra, y en un entrenamiento esas diferencias minúsculas se van acumulando. Así que es importante fiarse de las cifras de cientos de casos, y no de lo que pase con uno suelto.
Probarlo en tu refugio
Si ya instalaste la terminal del artículo anterior, no necesitas nada más (solo un pull, eso sí). Lo más cómodo es arrancarla y entrar en > entrenar(), que desde ahí se calibra, se entrena, se evalúa y se cambia de cerebro sin reiniciar nada. Si eres más de consola, en el README de entrenamiento/ tienes todos los comandos, y también cómo hacer que la terminal arranque directamente con el cerebro entrenado.
Si quieres entrenarlo para tus propias decisiones, escribe las situaciones en el mismo formato (el estado, las preguntas y la respuesta correcta de cada una) y pásaselas a los scripts con --datos. Ten en cuenta que esta LoRA se ha especializado en los casos de zombis del parking y el control de acceso a la puerta norte, así que con preguntas nuevas lo suyo es entrenar con ellas.
Esa noche
Cuando le enseñé los resultados a Julia, estuvo un buen rato mirando los fallos de la puerta norte.
—Bueno, ahora acierta bastante más, y cuando no lo tiene claro avisa. Algo es algo.
—Más o menos. Aunque cuando duda entre cuarentena y dejarlos fuera, los deja fuera.
—Pues casi mejor —dijo, mientras pasaba de página en el bloc—. Prefiero un superviviente fuera antes que un infectado aquí dentro.
Moraleja: no te hagas el enfermo delante de Julia ni aunque sea en broma, porque a las primeras de cambio te vas fuera.
LoRA viene del artículo LoRA: Low-Rank Adaptation of Large Language Models (Hu et al., 2021). Está pensado para LLM enormes, pero, como has visto, con un modelo pequeño como Laya también se defiende. Sobre la calibración con temperatura, el texto de referencia es On Calibration of Modern Neural Networks (Guo et al., 2017), que mostró que las redes neuronales modernas salen muy confiadas y que con una sola temperatura se corrige buena parte del problema.
Todo esto está tomando forma de libro: Desarrollo con IA en un Apocalipsis Zombi, el tercero de la saga. Aún está en preparación; en su ficha tienes el índice y lo que ya se puede contar. Si quieres que te avisen cuando salga, sigue al autor en Amazon: el refugio no manda correos, pero Amazon sí.