
Introducción a las neuronas artificiales
22-06-2025
Para bien o para mal, la Inteligencia Artificial hoy está en todas partes. Muchas personas se centran en explicar los distintos modelos, pero en este artículo me gustaría que llegáramos hasta el nivel más bajo de este mundillo, lo que es la mínima unidad de inteligencia artificial: una neurona.
A continuación aprenderemos desde los conceptos básicos, hasta como hacer que una sola neurona resuelva un problema lógico como una sencilla operación booleana AND.
Y como quiero innovar un poco, esta última parte más práctica no será con código Python (del cual hay miles de ejemplos), sino con JavaScript, ya que la idea es demostrar que con cualquier lenguaje podemos llevar a cabo la mayor parte de ideas en general.
¿Qué es una neurona artificial?
Básicamente, una neurona artificial es un modelo matemático inspirado en nuestras neuronas biológicas.
Su algoritmo más básico consiste en lo siguiente:
- Empieza su aprendizaje con ejemplos. Le damos una lista de combinaciones de entradas junto con la salida que esperamos. Por ejemplo, para enseñarle la operación lógica AND:
Entradas | Salida
[0, 0]   | 0
[0, 1]   | 0
[1, 0]   | 0
[1, 1]   | 1
- Ajusta los “pesos” de cada entrada. Estos pesos determinan cuánto influye cada entrada en el resultado. Al principio son aleatorios, pero tras ver muchos ejemplos, los va ajustando para acercarse cada vez más a la salida correcta según los errores que vaya obteniendo. -- Cuando ya ha practicado lo suficiente, le damos una nueva entrada y la neurona predice el resultado. Y sí, hablamos de una predicción, no de una fórmula exacta. A veces acierta, otras se aproxima... como cualquier modelo de IA.
A este último paso, es decir, al de proporcionar entradas para obtener una salida lo llamamos activar la neurona. El usar dicho verbo viene directamente de cómo funcionan las neuronas reales en nuestro cerebro: una neurona recibe señales a través de sus conexiones, las procesa, y si la señal es suficientemente fuerte, se activa y dispara una respuesta eléctrica.
El siguiente esquema muestra el flujo básico de aprendizaje:
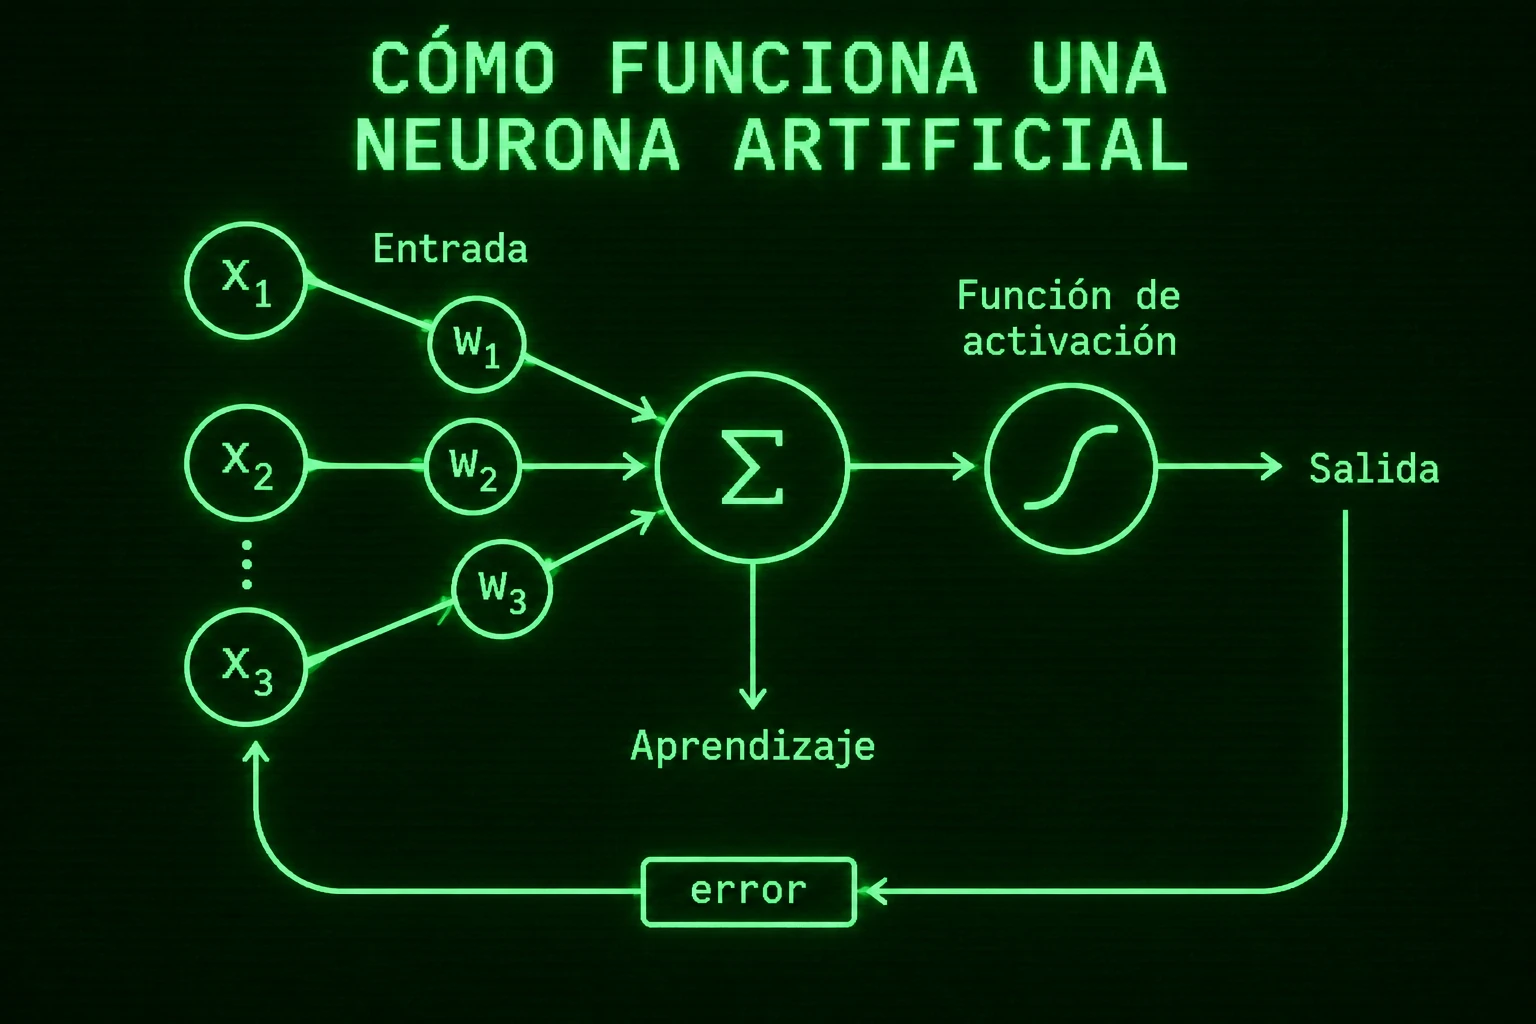
¿Pero cómo “aprende”?
El aprendizaje de una neurona artificial no es más que un proceso de prueba y error. Le damos ejemplos, calcula una salida, ve cuánto se ha equivocado y ajusta sus parámetros internos para hacerlo mejor la próxima vez. Este proceso seguro que te suena, pues lo que hacemos cuando aprendemos una habilidad nueva, ya sea programar, aprender a tocar un instrumento musical, etc.
Pero yendo a la parte más técnica. ¿Qué parámetros son los que ajusta la neurona?
- Pesos: cada entrada tiene un peso asociado. Es como decirle a la neurona “esta entrada es más importante que esta otra”. Al principio, esos pesos son aleatorios, pero la neurona los ajusta poco a poco durante el entrenamiento.
- Sesgo (o bias): es un valor adicional que se suma al total antes de aplicar la función de activación. Sirve como una especie de empujón extra, permitiendo que la neurona genere salidas más flexibles. Piensa en él como el “estado de ánimo” base de la neurona: si está muy alto o muy bajo, afecta al resultado aunque las entradas sean las mismas.
- Función de activación: una vez sumamos todas las entradas multiplicadas por sus pesos y le añadimos el sesgo, ese valor pasa por dicha función, que lo que hace básicamente, es convertir ese número a algo que tenga sentido como “respuesta”. Le da no linealidad al sistema, permitiendo que aprenda comportamientos complejos.
Entonces, en cada iteración de la fase de aprendizaje, la neurona:
- Predice un resultado a partir de las entradas y los pesos que tenga guardados.
- Compara ese resultado con la salida esperada, o lo que es lo mismo calcula el error.
- Usa el error de la salida para ajustar los pesos y el sesgo, guiándose por la derivada de la función de activación.
- Repite el proceso.
¿Cuántas veces hay que entrenarla?
Una pregunta común es: ¿cuántas veces hay que entrenar una neurona artificial?
Para eso usamos el número de épocas o iteraciones, es decir, cuántas veces la neurona recorre todos los ejemplos para ajustar sus pesos y su sesgo.
Si usamos muy pocas iteraciones, la neurona apenas aprende. Los pesos se quedan mal ajustados y la predicción será incorrecta en muchos casos. Pero si usamos demasiadas, también puede ser un problema. ¿Por qué?
- Sobreajuste (overfitting): Aunque en un problema tan simple como un AND o un OR esto no se nota mucho, en problemas reales con muchos datos, entrenar en exceso puede hacer que la neurona “memorice” los datos de entrenamiento y no sea capaz de generalizar cuando le damos datos nuevos.
- Pérdida de tiempo y recursos: Cada iteración consume tiempo y potencia de cálculo. Si después de cierto punto el modelo ya no mejora, seguir entrenando es simplemente ineficiente.
- Oscilación de pesos: Si no se ha afinado bien la tasa de aprendizaje, demasiadas iteraciones pueden provocar que los pesos “se pasen de largo” en cada ajuste, impidiendo que la neurona estabilice una solución.
Por eso, buscar el equilibrio es la clave. ¿Siempre deberemos usar el mismo número de iteraciones? Pues como diría Pau Donés: "depende". En ejemplos sencillos como las operaciones AND u OR, 1000 iteraciones funcionan bien. Pero en problemas más grandes, elegir el número de iteraciones se convierte en toda una ciencia.
Caso práctico
La clase Neuron
Esta clase representa una neurona artificial, y tiene todo lo necesario para poder entrenarse y activarse posteriormente.
Sus atributos son los siguientes:
learningRate: tasa o ratio de aprendizaje. Permite ajustar la desviación de los pesos en cada iteración del entrenamiento.bias: almacena el sesgo calculado. Puedes ver más arriba información sobre el sesgo.weights: almacena los pesos. Igualmente, puedes ver en qué consisten más arriba.inputsNumber: es importante almacenar el número de entradas que permite la neurona. Esté será el atributo que lo guarde.activationFunction: función que actuará como una especie de "filtro" que transforma el resultado en crudo calculado por la neurona es un valor normalizado. Hay varios tipos de funciones de activación según el uso que se le quiera dar a la neurona. Algo que comentaremos en futuros artículos.derivateFunction: sería la función derivada de la de activación. Nos servirá para ajustar el sesgo. Es por ello, que siempre dependerá de la función de activación.
Además de los métodos:
activate: se encarga de activar la neurona, es decir, darnos un resultado a partir de una serie de entradas.training: inicia el entrenamiento de la neurona. Recibe un conjunto de datos (por cada dato tenemos una o varias entradas y una salida). Además, recibe el número de iteraciones que hay que realizar para entrenar cada dato.train: método privado que realiza el entrenamiento de un dato.adjust: como su nombre indica, este método, se encargará de ajustar tanto los pesos como el sesgo a partir del error entre la salida real y la esperada.calculateError: nos devuelve el error entre la salida esperada y la generada por la neurona.calculateAdjust: obtiene el valor ajuste que hay que realizar a partir del error.
class Neuron {
  #learningRate = 0.1;
  #bias;
  #weights;
  #inputsNumber;
  #activationFunction;
  #derivateFunction;

  activate(inputs) { }
  training(dataset, epocas) { }
  #train(inputs, expectedOutput) { }
  #adjust(inputs, gradient, learningRate) { }
  #calculateError(expectedOutput, obtainedOutput) { }
  #calculateAdjust(error, generatedOutput, derivateFunction) { }
}
Entrenamiento
Para cada paso del entrenamiento tendríamos lo siguiente:
#train(inputs, expectedOutput) {
  const computedOutput = this.activate(inputs);
  const error = expectedOutput - obtainedOutput;
  const adjustValue = error * derivateFunction(computedOutput);

  this.#adjust(inputs, adjustValue, this.#learningRate);
}
Este método hace cuatro cosas muy importantes:
- Activa la neurona con las entradas actuales. O lo que es lo mismo, obtiene la salida calculada por la neurona con los pesos que tenemos actualmente (computedOutput)
- Calcula el error comparando lo que salió con lo que esperábamos.
- Usa la derivada de la función de activación para calcular cuánto debe ajustarse.
- Finalmente, ajusta pesos y sesgo.
Para este ajuste de pesos tenemos el método privado #adjust.
En JavaScript los atributos y métodos privados usan como prefijo la almohadilla #.
#adjust(inputs, adjustValue, learningRate) {
  for (let i = 0; i < this.#inputsNumber; i++) {
    this.#weights[i] += inputs[i] * adjustValue * learningRate;
  }
  this.#bias += adjustValue * learningRate;
}
Este es el método crucial para que funcione el proceso de aprendizaje de la neurona. Realiza el ajuste de pesos según el valor que calculamos de desviación con la derivada. Lo que debería ir reduciendo los errores entre la salida esperada y la obtenida.
Además, en esta parte incluimos el ratio de aprendizaje (learningRate en el código), que será un ajuste para poder usarlo en la desviación.
Ahora para entrenar a nuestra neurona para realizar operaciones AND. Usaríamos los datos siguientes:
const andData = [
  { inputs: [0, 0], output: 0 },
  { inputs: [0, 1], output: 0 },
  { inputs: [1, 0], output: 0 },
  { inputs: [1, 1], output: 1 }
];

exports.andData = andData;
De forma que a partir de esos datos y de usar la función de activación sigmoide, podríamos comenzar el entrenamiento:
const neuron = new Neuron(2, activationSigmoid, derivateSigmoid, 0.1);
neuron.training(andData, 1000);
En este caso, estamos diciendo que la neurona:
- Tiene dos entradas
- Usa como función de activación, la función sigmoide y su derivada.
- Tiene una tasa de aprendizaje de 0.1. O lo que es lo mismo, irá haciendo ajustes de pesos de 0.1 por cada iteracion.
Finalmente, le damos los datos con los que entrenar y le indicamos que itere 1000 veces con dichos datos.
Activación
Como indicamos anteriormente, cuando activamos la neurona, hacemos referencia al momento en el que "piensa" y da una respuesta. No está aprendiendo, está actuando según lo que ya aprendió.
En nuestro código JavaScript la activación consistiría en lo siguiente:
activate(inputs) {
  let sum = this.#bias;

  for (let i = 0; i < this.#inputsNumber; i++) {
    sum += inputs[i] * this.#weights[i];
  }

  return this.#activationFunction(sum);
}
- Recibe los inputs, por ejemplo [1, 1].
- El valor inicial parte del sesgo que calculamos durante el aprendizaje.
- Multiplica cada input por su peso correspondiente, ya que durante el entrenamiento a cada entrada le dimos "una importancia" diferente.
- Suma la multiplicación de todos los pesos con el sesgo.
- Pasa ese resultado por la función de activación, que como vimos terminará actuando como un filtro. En este caso, al usar como función de activación, la función sigmoide, transforma ese número crudo en un valor entre 0 y 1.
Con lo que al método anterior, si le damos [1, 1] como entrada, y está bien entrenada, nos devolverá algo cercano a 1. Si le damos [0, 1] o [1, 0], nos devolverá algo cercano a 0. Y es que cabe destacar que la salida no es un uno o un cero exacto. En nuestro ejemplo, como la función de activación devuelve valores continuos, puede darnos algo como 0.97 (que interpretamos como "casi 1") o 0.04 (que interpretamos como "casi 0").
En nuestro caso real, la salida será algo como:
Inputs: [0, 0] - Output: 0.01681626098863126
Inputs: [0, 1] - Output: 0.19194909494974405
Inputs: [1, 0] - Output: 0.19261658021780448
Inputs: [1, 1] - Output: 0.768161278046628
Finalmente
El código que he generado durante el desarrollo de este artículo lo he publicado en GitHub. En intentado poner bastantes comentarios, principalmente en la clase Neuron, para que os pueda ser más sencillo seguirlo. Ya que explicarlo al completo en este artículo se haría demasiado extenso.
Aún nos queda mucho por aprender, por lo que en futuros artículos:
- Veremos que aunque con nuestro código actual podemos obtener buenos resultados para las operaciones AND y OR. Cuando pasamos a una operación XOR debemos subir un nivel y crear nuestra primera red neuronal.
- Hablaremos un poco más de las distintas funciones de activación y en qué casos deberíamos usar cada una.
- Aprenderemos a persistir la información de las neuronas, para evitar entrenarlas cada vez.
Para terminar, como ejercicio sencillo si descargáis el código: probad a entrenar una neurona para que funcione con las operaciones OR.
Todo esto está tomando forma de libro: Desarrollo con IA en un Apocalipsis Zombi, el tercero de la saga. Aún está en preparación; en su ficha tienes el índice y lo que ya se puede contar. Si quieres que te avisen cuando salga, sigue al autor en Amazon: el refugio no manda correos, pero Amazon sí.