
Modelos de decisión: introducción a Laya
26-09-2026
El cerebro de un zombi es un modelo de decisión
Llevábamos tres semanas en el refugio de la vieja central eléctrica. Necesitaba un poco de aire así que salí a la terraza. Allí estaba Julia anotando observaciones en un desgastado bloc de notas. Me invitó a que me acercara en silencio.
—Ven —dijo susurrando—. Tienes que ver esto.
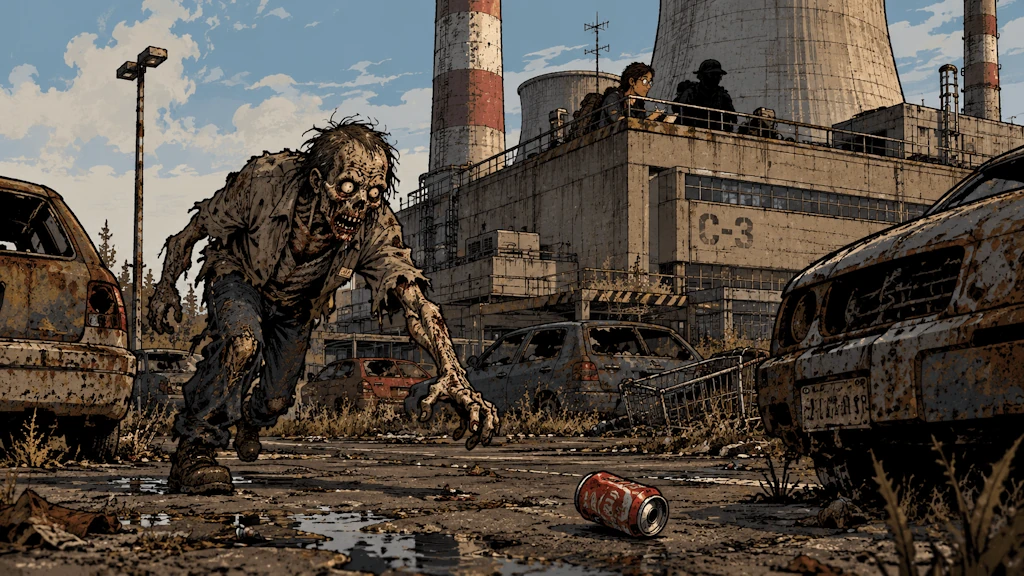
En el parking inferior se veía al típico infectado de manual, con una desgarrada camisa de oficinista y media pierna destrozada, lo que le provocaba una cojera ya irreparable. Julia tiró una lata vacía a su izquierda, sobre un grupo de bolsas de basura, lo que amortiguó parte del sonido. El zombi giró la cabeza y terminó ignorando el sonido. Luego tiró otra lata a la derecha sobre el asfalto, lo que provocó que comenzase a rodar. El zombi se quedó quieto un instante y echó a cojear rápidamente hacia la segunda lata.
—¿Ves? Aunque parece que no piensa —dijo Julia—. Ha decidido ir a la zona donde el ruido era más fuerte.
Y ahí se me encendió la bombilla que llevaba semanas apagada. Ese zombi no parecía razonar, tampoco era capaz de hablar y mucho menos de escribir poemas sobre su trágica existencia. Sólo recibía estímulos (ruido, olor, luz, distancia) y su atrofiado cerebro tomaba una decisión casi de forma instintiva: rastrear, atacar o ignorar.
Un poco de historia
Este mes ha aparecido un tipo de inteligencia artificial que funciona igual que aquel zombi. Bueno... más o menos.
Hasta ahora, estábamos acostumbrados a que cuando queríamos que una IA clasificase algo, lo normal fuera pedírselo a un LLM (ChatGPT, Claude, Gemini y sus amigos) especificando en el prompt que respondiese con un JSON: «dime si este mensaje es urgente y devuélvemelo en este formato». Y la verdad es que funcionaba... Casi siempre. El resto de las veces el modelo se ponía amable y te colaba un «¡Claro! Aquí tienes el JSON que me pedías:», o lo envolvía en un bloque de markdown, o se inventaba atributos. Ya sabes, cosas de LLMs.
El problema es que cada una de esas palabras de cortesía tarda en generarse y además no sale gratis. Para elegir entre tres opciones, le estábamos diciendo a un buen novelista que escribiera unos tristes formularios.
El 15 de septiembre de 2026, TypeSafe AI presentó Jev, su primer «System One Model». Eso último viene de Daniel Kahneman y su libro Pensar rápido, pensar despacio, donde divide nuestra forma de pensar en dos. Quizás ya te suene:
- El Sistema 1 es rápido e instintivo. Es el que te hace correr cuando tienes un infectado a medio metro.
- El Sistema 2 es el lento y deliberado. El que utilizas para hacer la declaración de la renta.
Los LLM juegan en la liga del Sistema 2 (o al menos lo intentan los pobres), pero Jev aspira a ser el Sistema 1. Como nuestro querido infectado perdido en el parking.
TypeSafe lo resume en una frase: «unstructured state in, typed probabilistic decisions out». Si lo traducimos para evitar que uses el Sistema 2: le das una descripción desordenada de la situación y te devuelve una decisión, de entre las que tú hayas permitido, acompañada de su probabilidad.
Pero, ahí no acaba la cosa. Tres días después, el 18 de septiembre, Convai Innovations, una empresa india dirigida por Nandakishor Mukkunnoth, publicó Laya. Prácticamente, parte de la misma idea, pero con una diferencia que para nuestro refugio con conexión inestable se agradece mucho: los pesos son abiertos, la licencia es Apache 2.0 y además funciona casi en una cafetera.
Laya es el que usaremos más adelante para simular el cerebro del zombi. Pero antes toca entender qué diantres es todo esto.
Para que te hagas una idea, he conseguido moverlo en CPU, una vieja i7-6500U. Y el tiempo que tarda en responder es inferior al segundo para operaciones sencillas, y con operaciones múltiples menos de dos segundos.
Qué es un modelo de decisión
Ya lo comenté antes, pero aquí vuelve el cansino. Un LLM escribe su respuesta poco a poco: cada palabra depende de las que ya ha escrito y, hasta que no pone el punto final, como con las cajas de bombones, nunca sabes lo que te va a tocar.
Pero, un modelo de decisión no escribe nada. Actúa como cuando era joven (ah, que recuerdos), y me tocaba hacer un examen tipo test. Leía el enunciado entero de un vistazo, miraba las opciones y marcaba la casilla que creía más probable.
Por dentro son modelos pequeños (para lo que se estila hoy). Laya, por ejemplo, anda entre los 320 y los 420 millones de parámetros, cuando los LLM grandes se miden en cientos de miles de millones. Pertenece a la familia de BERT, una especie de primo segundo de los LLM, que lleva desde 2018 dedicándose a intentar mejorar la comprensión del texto mientras el resto de modelos se llevaban la fama.
Volviendo a los modelos de decisión, lo que de verdad cambia las cosas es de dónde salen las opciones. En un clasificador de los de toda la vida, las etiquetas se deciden al entrenar el modelo, por lo que si quieres añadir una nueva toca gastar horas y horas en volver a entrenar. Con estos modelos no. Las opciones se las das tú en cada pregunta, junto con una descripción de cuándo aplica cada una, y el modelo reparte el 100 % de la probabilidad entre ellas. Si mañana el zombi aprende a trepar (por nuestro bien que no lo haga), bastaría con añadir la opción de «trepar» a la lista.
Tres tipos de pregunta
Estos modelos no admiten preguntas libres. Solo saben responder a tres tipos de cuestiones, así que el primitivo cerebro de nuestro amigo del parking sólo trabajará con lo siguiente:
| Tipo | Qué pregunta | Qué devuelve | En el cerebro del zombi |
|---|---|---|---|
choice |
¿Cuál de estas opciones? | La opción elegida y la probabilidad de cada una | ¿Atacar, seguir, ignorar o vagar? |
score |
¿En qué punto de esta escala? | Un valor dentro de una escala ordenada | ¿Cuánta hambre tiene: nada, algo o mucha? |
noul |
¿Es cierta esta afirmación? | La probabilidad de que lo sea, de 0 a 1 | ¿Huele a humano vivo? |
Y ya está. No hay más. No existe un cuarto tipo que nos permita decir «cuéntame qué siente el zombi». En un modelo de decisión si la pregunta no se puede responder marcando una casilla o señalando un punto en una escala, automáticamente es ignorada.
¿Qué es lo que ganas al usarlos?
Lo primero que se nota cuando los pruebas es la velocidad. Laya responde a una pregunta en unos 40 milisegundos en una tarjeta gráfica de servidor de las modestas, y como ya indiqué antes, en un portátil sin tarjeta gráfica tarda entre medio y un segundo. Además, todas las preguntas de una misma llamada se resuelven a la vez, así que tiene la ventaja de que preguntarle diez cosas no tarda diez veces más.
Si no fuera poco lo anterior, todo eso ocurre en tu PC. Ya que es un modelo de unos cientos de megas que corre en tu máquina y no depende de ninguna API, ni de la conexión (bueno para descargarlo sí, como es obvio). Créeme, cuando estás en un refugio cuya antena de la azotea está sujeta con cinta americana, esto no es un detalle menor.
Pero una de las cosas que más me gusta es que nunca, pero de verdad que nunca, te va a responder con algo que no esté en la lista que le has proporcionado. El propio texto de presentación de Laya justamente presume de que no hay nada que alucinar (nothing to hallucinate). Así que se acabó el JSON con saludo incluido o el «atacár» con tilde que rompía el switch.
Ojo, que no alucine no quiere decir que acierte. Ya que se equivoca, y bastante más de lo que me gustaría (lo veremos más adelante), pero al menos siempre que se equivoca es proporcionado los valores de tu lista.
Hacer pensar al zombi: ingeniería de decisiones
Con un LLM hacemos lo que se ha dado en llamar prompt engineering. Escribes instrucciones cada vez más largas, pero si algo falla pones en mayúsculas lo IMPORTANTE y cruzas los dedos. Con un modelo de decisión eso sirve de poco, porque no hay instrucciones largas que leer. El trabajo está en diseñar bien las preguntas, algo que podríamos llamar ingeniería de decisiones.
Esa noche, con la central a oscuras y una linterna de dinamo que había que recargar cada diez minutos (Julia y yo nos íbamos turnando porque era un rollo estar con la manivela todo el rato), nos pusimos a pensar en el posible diseño que simulara el cerebro del zombi que habíamos estado observando.
Lo que percibe
Lo primero es el estado, es decir, todo lo que el zombi percibe en un momento dado. Puede ser texto libre, pero siempre es recomendable tener un diccionario, porque te obliga a pensar qué información es la importante:
estado = {
    "ruido": "golpe metálico fuerte a unos 15 metros, a la izquierda",
    "olor": "sudor humano reciente, intenso, viene de la derecha",
    "luz": "anochecer, poca visibilidad",
    "distancia_presa": "unos 8 metros",
}
—¿Por qué pones «unos 8 metros» y no un 8 y ya está? —preguntó Julia.
Esto es debido a que tras las pruebas vimos que el cerebro del zombi lee, pero no es capaz de hacer cálculos. Un 8.2 suelto le dice bastante menos que «unos 8 metros». Las descripciones legibles funcionan mejor en estos casos. Es por ello que cuando haya que comparar números, lo ideal es hacerlo mediante código (en un momento vamos con eso).
Además, cabe destacar que el nombre de cada campo también lo lee. Con exactamente la misma escena, el zombi ataca con un 94 % de seguridad si la distancia va en un campo distancia_presa y con un 81 % si el campo se llama vista. Así que es buena idea elegir nombres que representen bien a qué corresponde cada campo.
Una vez que hayas escogido los nombres y veas que el modelo actúa bien con esa combinación en la mayor parte de casos, evita cambiar los nombres, ya que cada cambio mueve los porcentajes.
Lo que decide
Ya tienes el estado que debe analizarse, lo siguiente es saber será preparar la lista de decisiones. Es decir, sobré qué quieres obtener los datos probabilísticos. Cada decisión pasa así a convertirse en una pregunta.
Julia estuvo dándole vueltas y al final pensó en esta lista: qué hace el zombi a continuación, cuánta hambre tiene y si hay un humano cerca.
Una pregunta, una sola cosa
Julia se vino arriba y apuntó: «¿Hay un humano cerca y está herido?».
Esa pregunta tiene un poquillo de trampa, y es que en realidad son dos. En ese caso el modelo tiene que elegir entre contestar mal a una mitad o mal a la otra.
Aquí vuelve nuestro gran amigo el Principio de Responsabilidad Única de SOLID, pero aplicado a las preguntas. Cada pregunta debería tener una sola razón para cambiar. Además, separar en varias sale gratis, porque todas las preguntas de una llamada se responden a la vez.
Criterios que se puedan evaluar
Y aquí viene la parte más importante de todo el artículo.
En una pregunta choice, cada opción lleva una descripción de cuándo aplica. Esa descripción es lo que el modelo comparará con el estado. Y claro tras sólo cinco minutos de observación Julia quiso adelantarse y escribió:
"atacar": "cuando le apetezca"
Esa indicación "cuando le apetezca" es un misterio para la ciencia, y para el modelo también. Un criterio útil debe describir cosas que se puedan ver y medir en el estado:
ACCIONES = {
    "atacar": "hay un humano vivo muy cerca y su olor es intenso",
    "seguir": "hay rastro de humano, pero lejos o poco claro",
    "ignorar": "solo hay ruidos o estímulos sin rastro de humano",
    "vagar": "no hay estímulos relevantes a su alrededor",
}
Fíjate también en que no se pisan entre sí. Si tuvieras algo como «está agresivo» y «está algo agresivo», el modelo tendría que adivinar dónde acaba una opción y empieza la otra, y seguramente terminaría eligiendo casi a boleo (muy seguro de sí mismo, eso sí).
Y una vez escritas las opciones, deberían quedarse así y en ese orden para siempre. El porqué ya lo verás un poco más adelante al llegar a la letra pequeña.
Pocas opciones
Mientras tanto, yo había empezado otra lista con los tipos de zombi que habíamos visto: corredores, reptantes, hinchados, los del traje de oficinista... Pero al llegar al número treinta, Julia me quitó el bolígrafo y me miró con cara de circunstancias.
Y es que hizo bien. Estos modelos se lían cuando la lista crece, y la propia documentación de Laya recomienda no pasar de unas 20 opciones. La solución es preguntar por niveles: primero si el zombi «caza», «se mueve» o «descansa», y después, según la respuesta, una segunda pregunta más fina.
Lo que se puede programar, se programa
Una vez que tenemos el estado y las preguntas, queda hacer un refactor más: tachar preguntas que puedan ser respondidas programáticamente.
Julia había apuntado «¿La presa está a menos de 2 metros?», y para eso nos sobra con un simple if:
if distancia_m < 2:
    accion = "atacar"
La razón de ser de estos modelos es existir para los juicios que no se pueden calcular, como «¿esto huele a humano?». Comparar números, contar o manejar fechas debería seguir haciéndose con código, ya que es algo casi instantáneo, testeable de forma determinista y que no da pie a interpretaciones.
Al terminar, en el bloc quedó un esquema que todavía conservo: el modelo decide y el código actúa. Y cuando es necesario explicar algo por escrito (el resumen para el tablón del refugio, por ejemplo), lo redacta un LLM. De esta forma, conseguimos que cada pieza realice una sola cosa.
La linterna, por cierto, se apagó justo en ese momento.
La letra pequeña
A los pocos días ya teníamos el emulador de cerebros zombi funcionando en el portátil del refugio. Y Julia se dedicó a intentar romperlo. Por desgracia no le costó mucho.
Recién salido de la caja, acierta poco
La primera sorpresa fue lo mediocre que era sin tocar nada. Y es que el propio model card ya nos advierte de ello: «Laya is a fast base to specialise, not a zero-shot decision engine». O sea, es una base rápida para especializarla con tus datos, no un oráculo listo para usar. En su propia batería de pruebas, el modelo base apenas mejora lo que sacarías eligiendo al azar; entrenado para tu tarea, acierta más de tres de cada cuatro veces.
En el refugio decidimos empezar con lo que venía por defecto y ver hasta dónde llegaba.
Se equivoca muy seguro de sí mismo
Cada respuesta viene con una probabilidad, y te puede parecer tentador leer un 0,95 como «acierta el 95 % de las veces». Pero no. Estos modelos salen de fábrica bastante más seguros de lo que deberían. Un caso muy curioso está en su propia documentación: con textos en jemer (el idioma de Camboya), el modelo inglés no acierta ni una y aun así responde con un 95 % de confianza. Tiene algo de cuñado: no sabe de nada, pero responde a todo con aplomo.
Por eso, antes de dejarle decidir nada solo, hay que medir. Y medir no es entrenar: al modelo no le enseñas nada, solo preparas situaciones de las que ya sabes la respuesta correcta y comparas con lo que dice él. Julia y yo etiquetamos a mano unas 150 situaciones que habíamos vivido (lo recomendable está entre 50 y 200) y comparamos lo que decía el modelo con lo que había pasado de verdad. Así se ve qué opciones confunde (en nuestro caso, «seguir» con «atacar», algo que no da pie a la tranquilidad) y se puede corregir ese exceso de confianza.
Después se fija un umbral. Si está por encima, podemos dejar que el modelo decida solo. Si está por debajo, es mejor que lo decida una persona. En el README de Laya se pone de ejemplo un 0,85. Pero en nuestro caso, en el refugio, cuando la decisión era crítica pensamos en subirlo bastante más.
El orden de las opciones importa
Es algo que mucha gente está pasando por alto. Si cambias el orden de las opciones, a veces cambia la respuesta.
Nos faltaban navajas y cuchillos para defender el refugio, pero estábamos entre dos opciones porque nos fallaba un poco la memoria por culpa del caos vivido. Así que le preguntamos al modelo adónde ir a buscarlas. Con las opciones [Albacete, Puertollano] nos mandó a Puertollano, con un 68 % de seguridad. Con [Puertollano, Albacete], a Albacete. En los dos casos eligió la segunda opción de la lista, que por lo visto le inspira más confianza que la cuchillería manchega. Al preguntar la capital de la provincia de Ciudad Real nos hizo exactamente lo mismo.
Y no es cosa de nuestros viejos equipos del refugio. Hay una prueba independiente con preguntas en chino y solo dos opciones en la que cambiar el orden alteró la respuesta en casi un tercio de los casos (allí le tocó a Tokio y Osaka).
Con lo que nos podemos quedar de todo esto es que en tus pruebas conviene barajar las opciones a propósito para saber cuánto te afecta el orden. Una vez que ves el caso estable defines el orden final y evitas cambiarlo.
Con todo lo anterior anotado, llegó la hora de comenzar con la parte práctica.
Manos a la obra: la terminal del refugio
Hasta aquí hemos visto una parte general sobre los modelos de decisión. Y luego hemos comentado algunas restricciones de Laya en concreto. Es la hora de comenzar a trabajar a fondo con ese modelo.
Laya tiene dos versiones que nos interesan. Una está entrenada para inglés y es algo más grande, con 421 millones de parámetros. La otra entiende más de cien idiomas, se queda en 322 millones y va bastante más rápida. La librería trae además un enrutador que mira en qué idioma está el texto y se lo pasa a la versión que mejor lo entiende. Como en nuestro refugio el idioma mayoritario era el español, usamos la multilingüe.
Para no tener que escribir código desde el primer minuto, preparé el Refugio de Laya: un pequeño servidor que carga Laya y lanza una terminal web de fósforo verde, como las que había en la central antes de que se fuera la luz. Trae de serie todos los ejemplos de este artículo.
Instalación
git clone https://github.com/jafs/laya-refugio.git
cd laya-refugio
TORCH_VARIANT=cu126 ./setup.sh   # con GPU NVIDIA; sin ella, ./setup.sh a secas
./run.sh
Y la terminal quedará esperando en http://localhost:8000.
La primera vez descarga el modelo multilingüe y lo guarda en la caché de Hugging Face. A partir de ahí siempre que arranque será sin conexión. Algo que nos viene genial porque en el refugio la cobertura va y viene.
Cuando termine, aparecerá la terminal con las seis situaciones del artículo a la izquierda. Cada una trae su estado, sus preguntas y, en muchos casos, algunas variantes para poder comparar resultados. Todo se puede editar, así que nada te impide inventarte tus propios zombis.
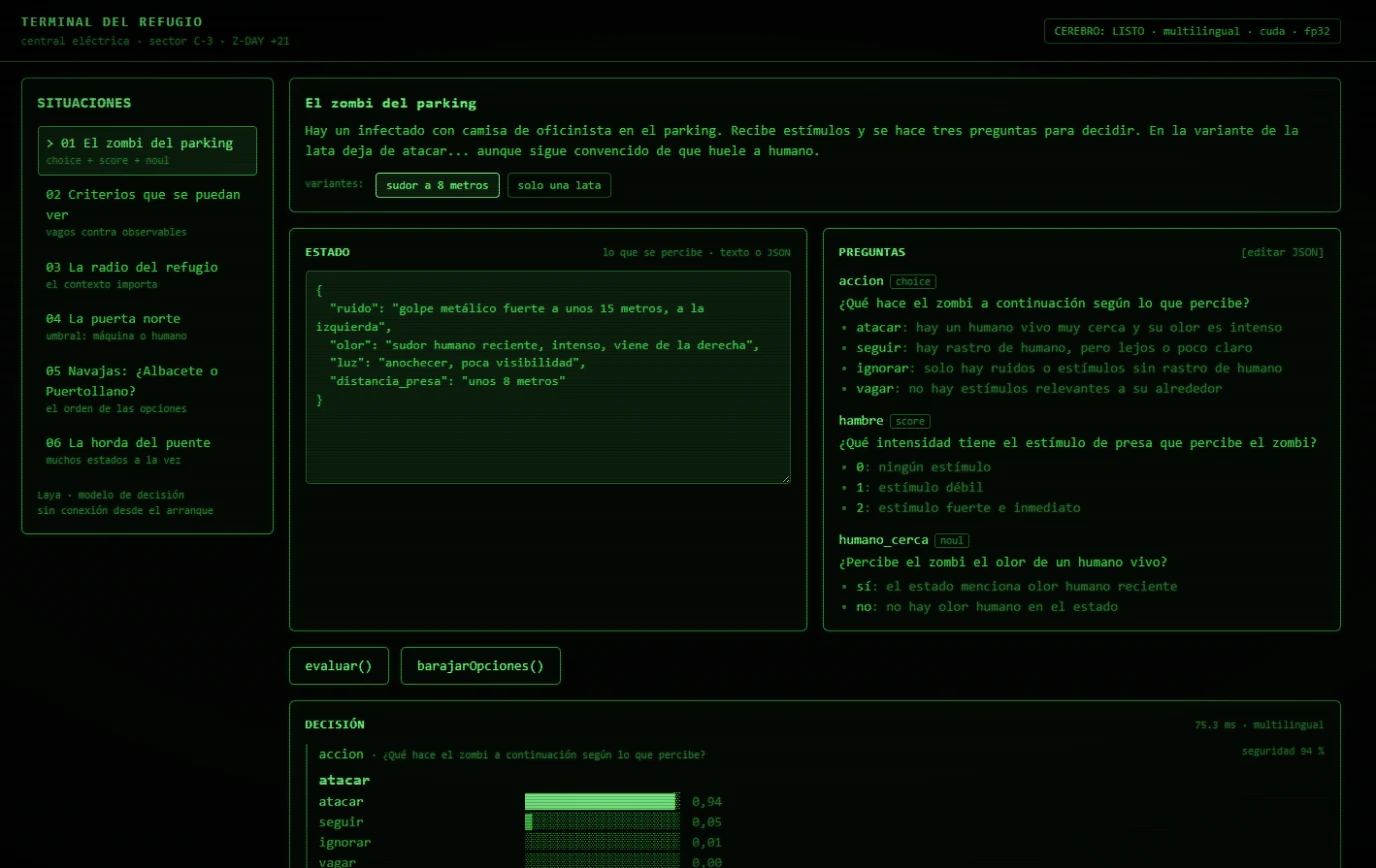
La terminal te permite también crear tus propios ejemplos. Con + nuevaPrueba() empezarás de cero. Tus pruebas aparecen aparte, en «MIS PRUEBAS», en ámbar (el otro color fosforito de toda la vida), para que no se confundan con las oficiales. Todo se guarda como ficheros JSON en la carpeta mis-pruebas/, con el mismo formato que los ejemplos, así que puedes pasárselas a otro refugio sin más que copiar los ficheros.
El zombi del parking, en código
La terminal es cómoda, pero por debajo no hay mucha magia la verdad. Y es que el cerebro del zombi cabe en unas poquitas líneas de Python (aunque no conozcas ese lenguaje verás que son muy sencillas):
import laya

cerebro = laya.load("convaiinnovations/laya", subfolder="multilingual")

estado = {
    "ruido": "golpe metálico fuerte a unos 15 metros, a la izquierda",
    "olor": "sudor humano reciente, intenso, viene de la derecha",
    "luz": "anochecer, poca visibilidad",
    "distancia_presa": "unos 8 metros",
}

preguntas = {
    "accion": {
        "type": "choice",
        "instructions": "¿Qué hace el zombi a continuación según lo que percibe?",
        "criteria": {
            "atacar": "hay un humano vivo muy cerca y su olor es intenso",
            "seguir": "hay rastro de humano, pero lejos o poco claro",
            "ignorar": "solo hay ruidos o estímulos sin rastro de humano",
            "vagar": "no hay estímulos relevantes a su alrededor",
        },
    },
    "hambre": {
        "type": "score",
        "instructions": "¿Qué intensidad tiene el estímulo de presa que percibe el zombi?",
        "criteria": ["ningún estímulo", "estímulo débil", "estímulo fuerte e inmediato"],
    },
    "humano_cerca": {
        "type": "noul",
        "instructions": "¿Percibe el zombi el olor de un humano vivo?",
        "criteria": {
            "true": "el estado menciona olor humano reciente",
            "false": "no hay olor humano en el estado",
        },
    },
}

respuesta = cerebro.predict(estado, preguntas)
print(respuesta["answers"]["accion"]["choice"])   # atacar
En el ejemplo superior esto es lo que contestó en el portátil del refugio, que lleva una GTX 1660 de hace unos cuantos años pero que resiste aún:
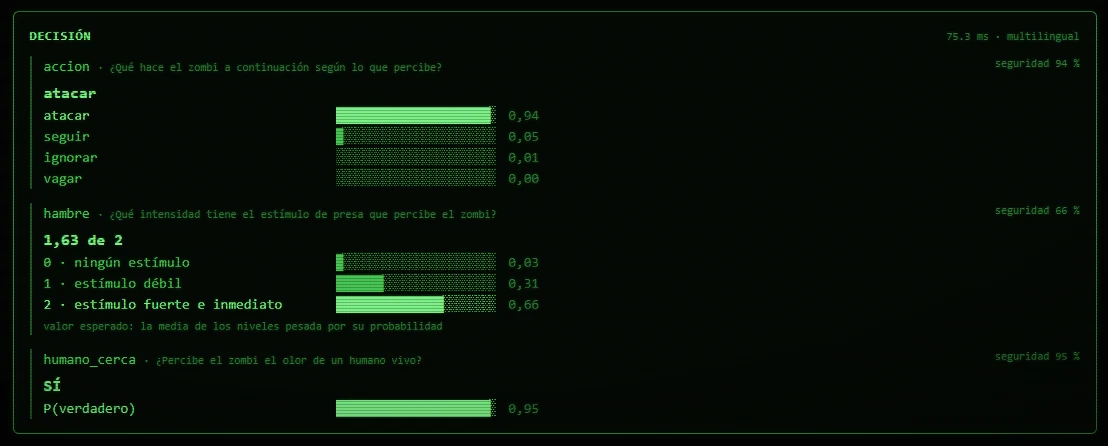
Atacar, con un 94% de seguridad. El hambre sale en 1,63 sobre 2: score no devuelve el nivel más probable, sino la media de los niveles pesada por su probabilidad, así que 1,63 quiere decir «entre débil y fuerte, tirando a fuerte». Todo en 75 milisegundos.
—Ahora quítale el olor —dijo Julia.
Así que definimos la variante «solo una lata» en la que el olor a sudor desaparece y la presa también. El zombi pasa a ignorar, con un 86%. Pero a la pregunta de si huele a humano vivo sigue respondiendo que sí, con un 94 %, aunque el estado dice literalmente "olor": "ninguno". Ya no ataca, pero sigue convencido de que huele a humano. Recuerda que un poco antes en el artículo hablamos de la letra pequeña.
El segundo ejemplo, el de los criterios, hace la misma pregunta dos veces en la misma llamada, una con los criterios del primer intento de Julia («cuando le apetezca») y otra con los que se pueden comprobar en el estado:
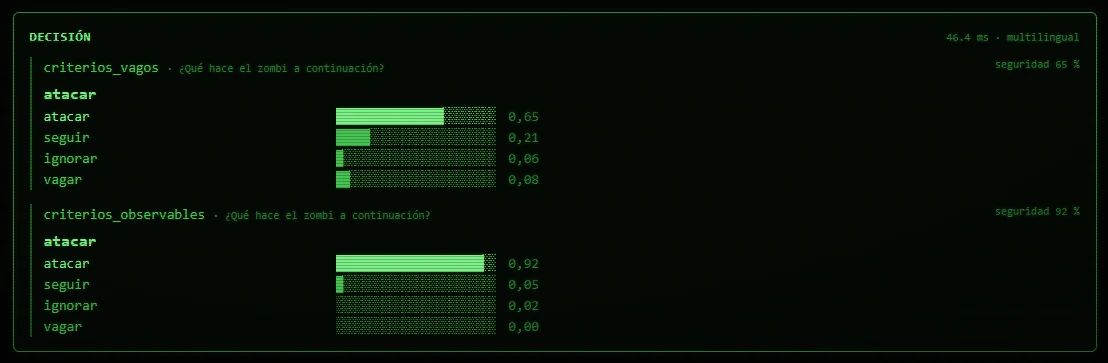
Los dos aciertan, pero el vago lo hace con un 65% y el observable con un 92%. Sin presa a la vista pasa lo mismo: 59% contra 84%. Con un umbral de 0,9, el primero nunca decidiría nada por sí mismo.
Pero también es posible ver como el contexto influye. En el ejemplo de la radio del refugio vemos justo para qué sirve. El mismo fragmento, «...no abráis...», sale como aviso de horda con total seguridad si antes se oyó «¡Una horda viene por la puerta norte!», y como comercio (98%) si lo anterior era alguien ofreciendo latas. Sin no hay mensaje anterior, el modelo apuesta por una petición de socorro con un 59%. Algo que dependiendo del caso, podría no estar mal visto.
Y también falla: «Un grupo grande baja por la avenida hacia el puente, más de cincuenta» sale como socorro, con un 76%. Como no se dice «zombis» en ningún momento, el modelo no se pone en lo peor.
La puerta norte
En este ejemplo veremos al umbral en acción. Si la máquina está segura al 90% o más, decide ella. Si no, tocara hacer que baje quién esté de guardia a mirar.
La mujer de la venda y el chico que trae una carta del polideportivo se quedan en un 70%, así que les toca guardia. El hombre de la piel grisácea, con marca de dientes en el cuello y que no hace más que gruñir, sale rechazado por un margen ridículo: 45% frente a un 42% de admitirlo.
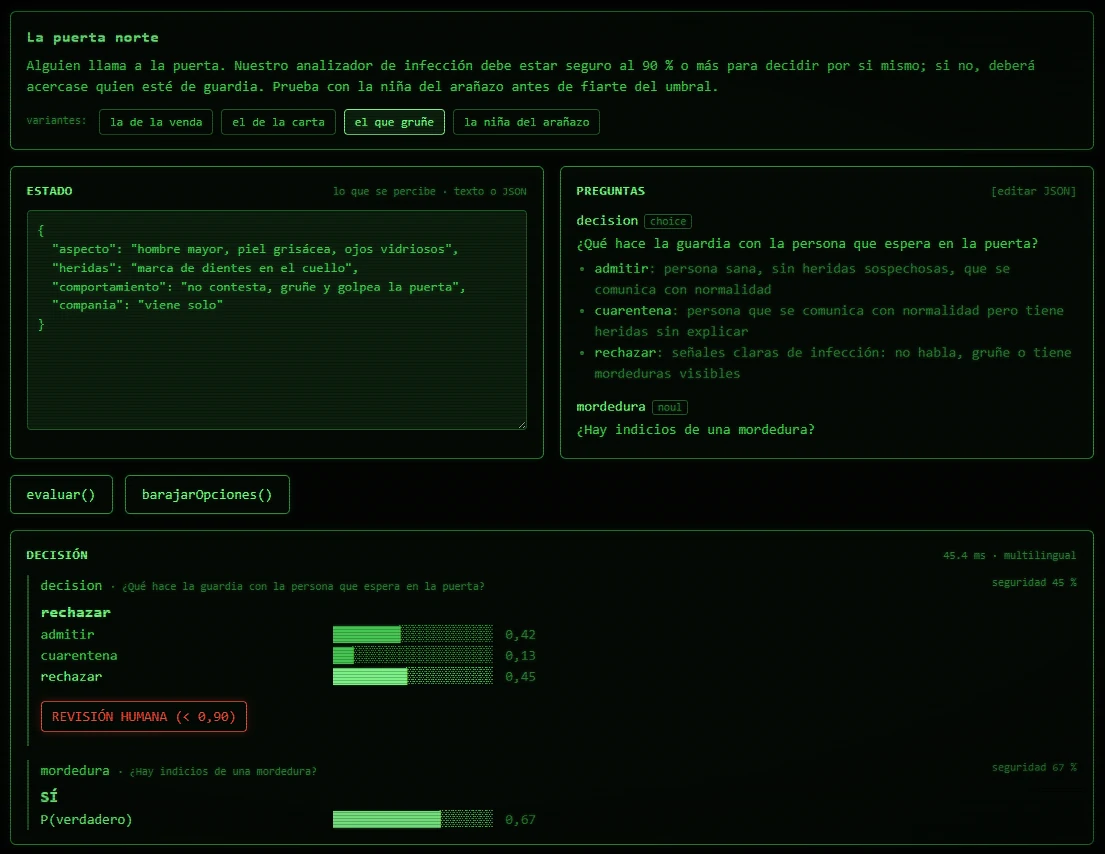
Menos mal que existe el umbral, si no en algún caso podríamos haber llegado a admitirlo si nos hubiésemos fiado sin comprobarlo antes, lo que nos hubiera puesto en un serio compromiso.
Por otro lado, el problema es la niña del arañazo reciente en la mejilla, que según su padre fue con una valla:
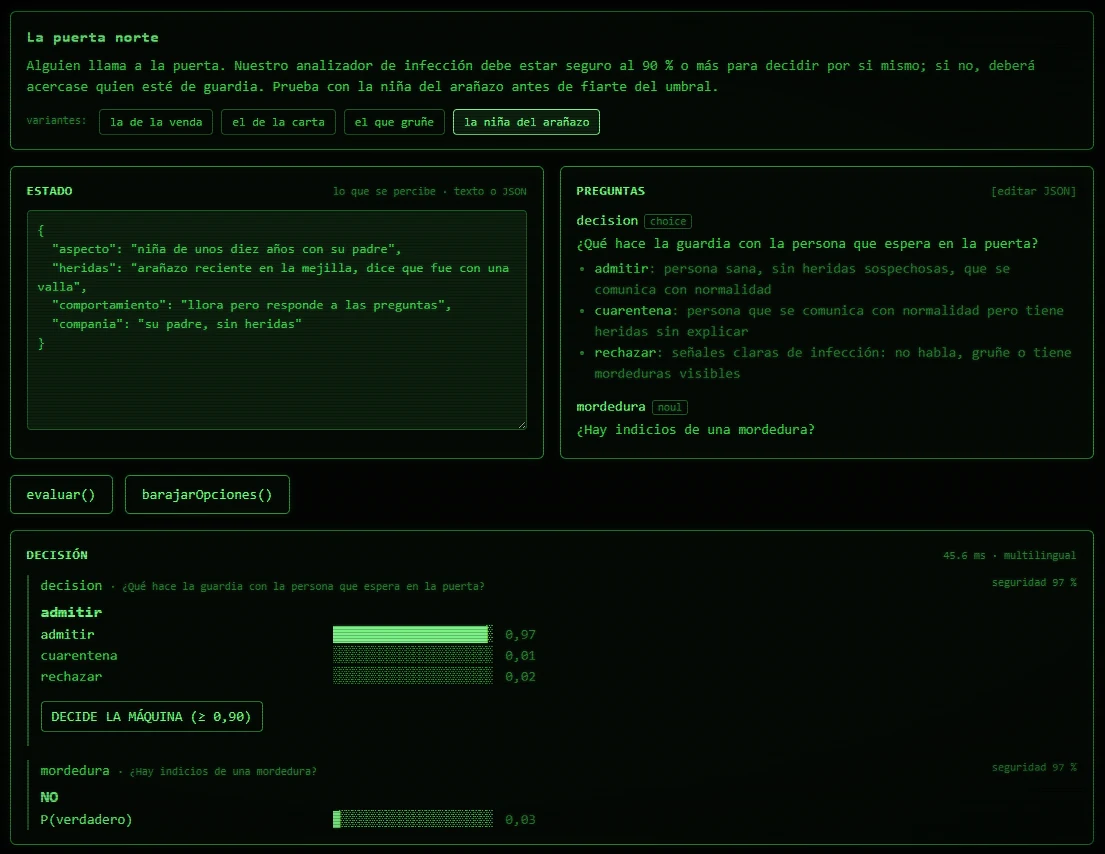
Admitida con un 97% de seguridad, sin que nadie baje a mirarla. Puede que el arañazo fuese con una valla. O puede que el padre mintiese.
Con todo esto, la lección es que un umbral solo protege si tenemos la seguridad de que hemos medido casos parecidos antes con el modelo. Es por ello muy importante que si no lo entrenamos, al menos le demos una gran cantidad de casos para probar tanto las preguntas que hacemos como los filtros.
Barajando navajas
El quinta caso es una muestra de que un cambio de orden modifica los resultados. En el terminal, el botón barajarOpciones() repite una pregunta con las opciones en otro orden y compara las respuestas. Con las navajas pasa lo que ya avisábamos con la letra pequeña:
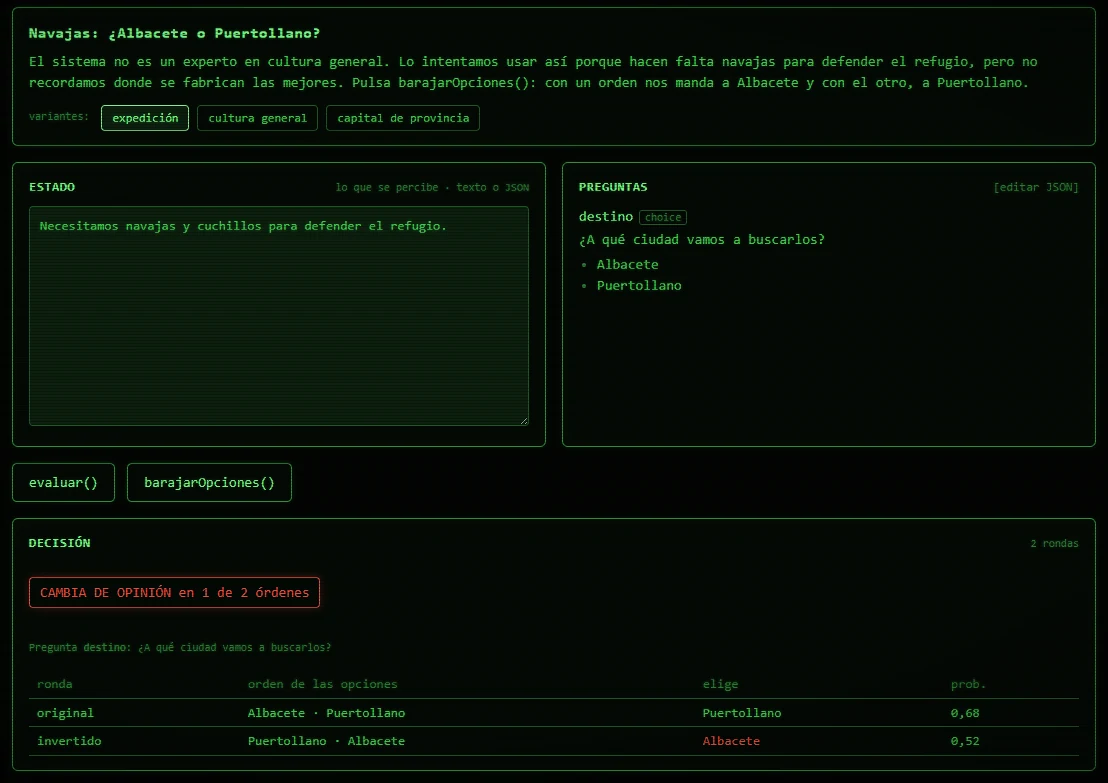
Como ya he ido repitiendo durante todo el artículo, prueba bien con tus propias preguntas antes de fiarte de ellas. Cuando veas que una respuesta baila al barajar las opciones, raro será que sea la única.
La horda del puente
Por último, ocho zombis cruzan el puente y el cerebro decide por todos en una sola llamada:
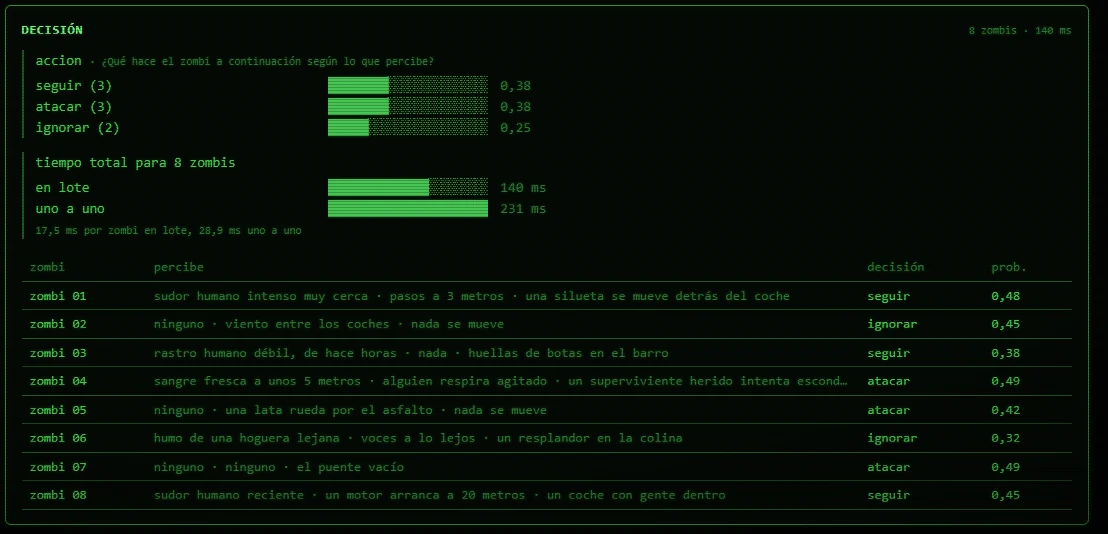
En lote tarda 18 milisegundos por zombi, frente a los 36 de preguntarle uno a uno. Con 64 zombis la diferencia es de 13 frente a 31. El README de Laya habla de mejoras mucho mayores en tarjetas modernas; en la trillada GTX 1660 la cosa es más modesta, pero aún así se nota.
Lo que más llama la atención es la tabla. El zombi 07 no huele nada, no oye nada, tiene delante un puente vacío... y decide atacar. Eso sí, ninguno de los ocho pasa del 50%. Con lo que si hubiera un revisor zombi, seguramente tendría que ir guiándolos porque no superan el 90% de umbral.
Una nota para quien tenga una GTX 16xx
Si vienes de un refugio como el mío en el que llevas mucho tiempo sin actualizar la tarjeta gráfica este aviso te puede interesar.
La primera vez que arranqué la terminal, cada decisión tardaba casi 300 milisegundos en la tarjeta gráfica, que para una GPU es una eternidad. Y es que Laya usa media precisión (fp16) en cualquier tarjeta NVIDIA, pero las GTX 16xx no tienen los núcleos especializados para eso (los tensor cores) por lo que la media precisión va unas tres veces y media más lenta que la normal: 234 milisegundos frente a 64. He hecho ajustes para que la terminal lo detecte y cambie sola a fp32. Si usas Laya por tu cuenta en una de estas tarjetas, en app/cerebro.py del repositorio tienes cómo hacerlo, así que puedes copiar la idea libremente.
De vuelta en la terraza
Unas semanas después volví a subir a la terraza. Julia seguía allí, con el bloc lleno de estados, criterios y porcentajes tachados. Abajo, en el parking, el oficinista de la media pierna perseguía una lata que había arrastrado el viento.
—Este no falla tanto como nuestra simulación —dijo sin levantar la vista—. Cada vez que suena algo, sale disparado a la zona del ruido.
—Me da que es porque su cerebro al final es más simple y solo se hace una pregunta con dos respuestas posibles.
—Bueno, hay muchos supervivientes así —reflexionó Julia—. Sólo ven blanco o negro pero se pierden los matices de gris.
Todo lo que has visto en la terminal está hecho con el modelo tal como se descarga, sin entrenarlo. Para seis situaciones y un puñado de opciones da para jugar, y a ratos para algo más. Pero si en tu refugio las decisiones son más complejas, o simplemente necesitas que acierte más de lo que acierta, toca hacer lo que dice la model card: especializarlo con tus datos. El proyecto incluye un cuaderno que te explica como hacer todo el proceso.
Desde entonces, antes de pedirle nada a una IA me hago la pregunta que quedó apuntada en la primera página del bloc: ¿necesito una respuesta o una decisión? Si es una respuesta, que la escriba un LLM. Si es una decisión y es determinista la programo y si no uso un modelo de decisión.
Con todo esto, hemos aprendido que nunca puedes fiarte de un zombi que dice estar seguro al 95%. Y menos si habla jemer.
Todo esto está tomando forma de libro: Desarrollo con IA en un Apocalipsis Zombi, el tercero de la saga. Aún está en preparación; en su ficha tienes el índice y lo que ya se puede contar. Si quieres que te avisen cuando salga, sigue al autor en Amazon: el refugio no manda correos, pero Amazon sí.