
DDD en un apocalipsis zombi. Parte 4
22-03-2026
En las tres entregas anteriores construimos los cimientos del refugio: el lenguaje ubicuo y los Bounded Contexts que hacen que todos hablen el mismo idioma, los Servicios de Dominio, Repositorios, capa de Aplicación y Eventos de Dominio que conectan el núcleo con el exterior, y las Sagas, antipatrones y tests que mantienen la integridad cuando las cosas se complican.
La noche del día 94 descubrimos a las malas, si todo lo aprendido nos había servido. Una horda más grande de lo habitual obligó a una evacuación urgente del Refugio 3 hacia el Refugio 7. El sistema procesó las órdenes, los registros parecían correctos, pero el contexto de Sanidad nunca recibió los avisos: tres supervivientes con heridas abiertas pasaron la noche sin revisión médica. Por la mañana, uno de ellos había infectado a su compañero de litera y hubo que cerrar toda la sala para contener el brote. El código era correcto. La infraestructura, no.
Hay tres puntos donde casi todos los equipos se estrellan cuando llevan DDD a producción. Este artículo va de esos tres puntos, de cómo construir las defensas que un simulacro no exige pero el ataque de una horda sí, y de ver todo el sistema funcionando de principio a fin.
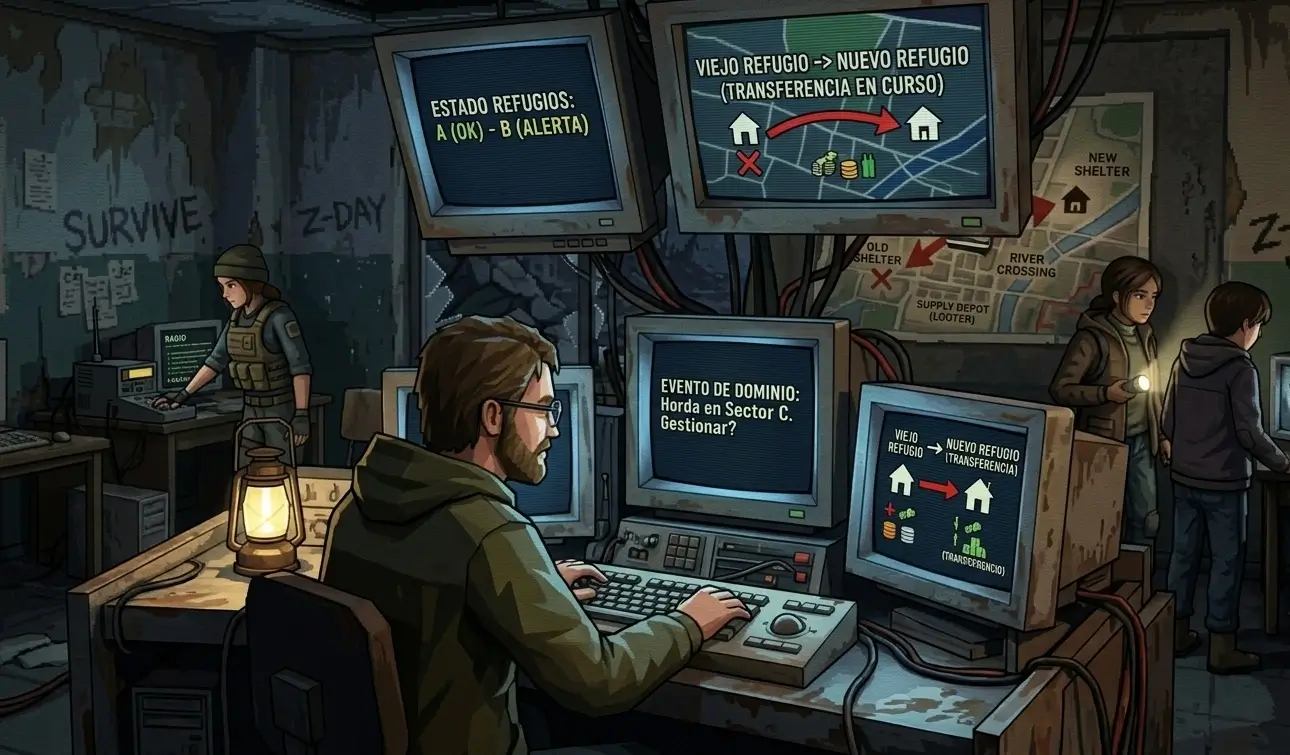
1. El dilema de la doble escritura y el patrón Outbox
En la segunda parte publicamos eventos así, justo después de guardar el agregado:
async handle(cmd: AdmitSurvivorCommand): Promise<void> {
  const shelter = await this.shelterRepo.findById(cmd.shelterId);
  shelter.admit(cmd.survivor);
  await this.shelterRepo.save(shelter);      // ← transacción en BD confirmada

  await this.eventBus.publish({              // ← si el sistema falla aquí...
    type: "SurvivorAdmitted",
    shelterId: shelter.id,
    survivorId: cmd.survivor.id,
    timestamp: new Date().toISOString()
  });
}
Y dejamos una nota al pie hablando de forma muy resumida del patrón Outbox. Lo que ocurrió la noche del día 94 es exactamente esa nota al pie hecha realidad.
El problema: dos infraestructuras, cero atomicidad
El código anterior intenta hacer dos cosas en dos infraestructuras distintas. La base de datos relacional y el bus de mensajes (Kafka, RabbitMQ o mensajes por Walkie Talkie) son dos sistemas independientes. No existe ningún mecanismo que garantice que ambas operaciones se completen o fallen juntas.
Si la red sufre un pico de latencia de un milisegundo entre el save y el publish, o si el proceso cae justo en ese instante, el refugio tiene al superviviente dentro pero el equipo de sanidad jamás recibe la notificación. El herido está en el recinto, sangrando en su litera, y nadie va a atenderle porque el sistema global está desincronizado. Eso fue exactamente lo que pasó la noche del día 94, multiplicado por tres.
Esto es el dilema de la doble escritura: cualquier intento de coordinar dos escrituras en sistemas distintos sin un mecanismo explícito de garantía está expuesto a este tipo de fallo silencioso.
La solución: el patrón Outbox
La idea es sencilla: en lugar de publicar el evento directamente al bus, lo guardamos en una tabla de la propia base de datos junto con el estado del agregado, dentro de la misma transacción SQL. O se guardan los dos o no se guarda ninguno.
// Tabla outbox_events en la base de datos
// id | event_type | payload (JSON) | created_at | processed_at (null = pendiente)

async handle(cmd: AdmitSurvivorCommand): Promise<void> {
  await this.uow.run(async () => {
    // Cargamos dentro de la unidad de trabajo para evitar lecturas sucias
    const shelter = await this.uow.shelters.findById(cmd.shelterId);
    shelter.admit(cmd.survivor);

    // 1. Guardamos el estado del agregado
    await this.uow.shelters.save(shelter);

    // 2. Guardamos el evento pendiente en la misma unidad de trabajo
    await this.uow.outbox.save({
      event_type: "SurvivorAdmitted",
      payload: JSON.stringify({
        shelterId: shelter.id,
        survivorId: cmd.survivor.id,
        timestamp: new Date().toISOString()
      })
    });
    // Si algo falla aquí, el Unit of Work revierte ambas escrituras
  });
}
Lo que aparece como this.uow representa el patrón Unit of Work que es una abstracción de la capa de aplicación que agrupa varias operaciones en una unidad atómica. El handler lo recibe por inyección de dependencias y solo sabe que uow.run() garantiza que o todo se persiste o nada se persiste. La implementación concreta —la que abre la transacción SQL, conoce Knex o Postgres y pasa el contexto a cada repositorio— vive en infraestructura. Así el caso de uso cumple la regla de dependencia: depende de abstracciones, no de detalles de la base de datos.
Podéis leer más acerca de él, en el fantástico libro Patterns of Enterprise Application Architecture de Martin Fowler
El estado del agregado y el evento quedan atómicamente vinculados. Ahora necesitamos algo que publique esos eventos pendientes.
El worker: de la tabla al bus
Un proceso en segundo plano lee periódicamente la tabla outbox_events y publica los eventos pendientes al bus:
export class OutboxWorker {
  constructor(
    private readonly eventBus: EventBus
  ) {}

  async processPendingEvents(): Promise<void> {
    const pending = await db("outbox_events")
      .whereNull("processed_at")
      .orderBy("created_at", "asc")
      .limit(10);

    for (const record of pending) {
      // Publicamos al bus de mensajes
      await this.eventBus.publish(JSON.parse(record.payload));

      // Solo cuando el bus confirma la recepción, marcamos como procesado
      await db("outbox_events")
        .where("id", record.id)
        .update({ processed_at: new Date() });
    }
  }
}
Este método se ejecuta cada pocos segundos vía cron, un setInterval o cualquier mecanismo de tareas periódicas que uses en tu stack.
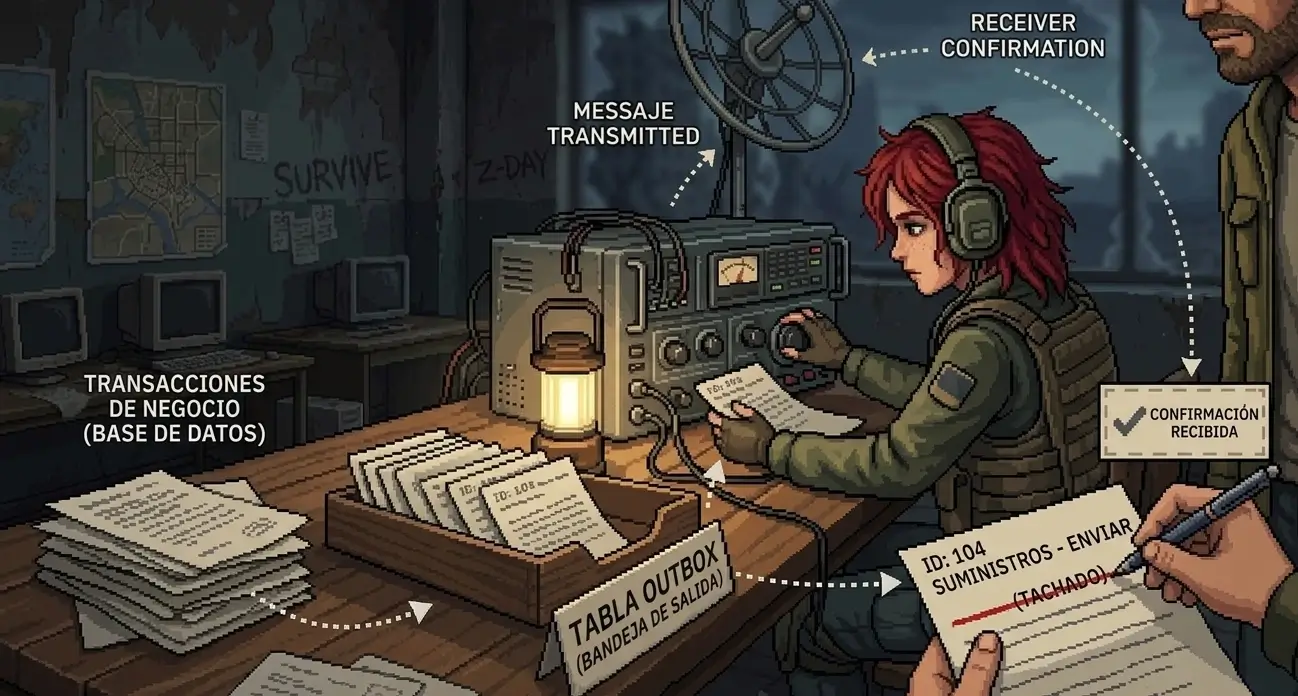
Piénsalo así: la tabla outbox_events es la libreta de papel que hay en la sala de radio del refugio. Cuando el guardia admite a un superviviente, anota la entrada en el registro principal y, en el mismo acto, escribe el mensaje pendiente en esa libreta. Las dos cosas ocurren juntas o no ocurre ninguna. El worker es la operadora de radio que revisa la libreta cada pocos minutos, transmite los mensajes pendientes por radio (el bus de mensajes) y, solo cuando recibe confirmación de que el destinatario los recibió, los tacha. Si se va la luz mientras transmite, la libreta sigue intacta: el siguiente turno del operador encontrará el mensaje sin tachar y lo retransmitirá. El corte de energía no se lleva el aviso.
Entrega de al menos una vez e idempotencia
La operadora de radio transmite el mensaje, la guardia del refugio de destino confirma que lo recibió, pero el operador pierde el conocimiento antes de tacharlo de la libreta. Al llegar el turno siguiente, el mensaje sigue sin tachar y se retransmite.
En términos de código: el worker publica el evento, el bus lo recibe y confirma, pero el worker cae justo antes de ejecutar el UPDATE processed_at. Al reiniciarse, verá ese evento todavía pendiente y lo enviará de nuevo.
Esto se llama entrega de al menos una vez (at-least-once delivery): el sistema garantiza que el evento llega, pero no que llega exactamente una sola vez. La consecuencia directa es que los consumidores deben ser idempotentes: capaces de recibir el mismo evento más de una vez sin efectos secundarios duplicados.
// El servicio de sanidad escucha admisiones
eventBus.on("SurvivorAdmitted", async (event) => {
  // Verificamos si ya programamos el chequeo para este superviviente
  const alreadyScheduled = await medicalRepo.hasCheckupFor(event.survivorId);
  if (alreadyScheduled) return; // Ignoramos el duplicado sin error ni efecto

  await medicalService.scheduleCheckup(event.survivorId);
});
Si el médico ya tiene programado el chequeo del superviviente 42 y recibe el aviso por segunda vez, simplemente lo ignora. No se asignan dos camas al mismo paciente. Esta propiedad no es opcional en un sistema que usa el patrón Outbox: es un requisito de diseño que todo consumidor de eventos debe cumplir.
Idempotencia en los handlers de comandos
La idempotencia no es solo responsabilidad de quien recibe los avisos de radio. El guardia en la puerta también puede recibir la misma orden dos veces: la señal del cuartel general se cortó y el operador la reenvió por si acaso. Sin protección, admitiría al mismo superviviente dos veces.
Los propios handlers deberían poder recibir el mismo comando dos veces sin efectos duplicados, algo habitual cuando hay reintentos de red o clientes que reenvían peticiones. La solución es incluir un commandId único en cada comando y registrar los ya procesados dentro de la misma transacción:
async handle(cmd: AdmitSurvivorCommand): Promise<void> {
  await this.uow.run(async () => {
    // Verificamos si este comando ya se procesó antes
    const alreadyProcessed = await this.uow.processedCommands.findById(cmd.commandId);
    if (alreadyProcessed) return;

    const shelter = await this.uow.shelters.findById(cmd.shelterId);
    if (!shelter) throw new Error("Refugio no encontrado");

    shelter.admit(cmd.survivor);
    await this.uow.shelters.save(shelter);

    await this.uow.outbox.save({ /* ... */ });

    // Registramos el commandId para detectar duplicados futuros
    await this.uow.processedCommands.save({
      command_id: cmd.commandId,
      processed_at: new Date()
    });
  });
}
Llevado al terreno del refugio, este identificador único es exactamente la hoja de control del guardia: anota el número de orden del cuartel general cuando procesa la señal. Si ese número ya está anotado, ignora el mensaje y no abre la puerta. La señal puede llegar dos veces; la puerta solo se abre una.
Los conceptos de doble escritura, idempotencia y entrega de al menos una vez están tratados en profundidad en Designing Data-Intensive Applications de Martin Kleppmann, probablemente el mejor libro sobre sistemas distribuidos modernos que existe.
Una nota sobre 2PC
Después de la noche del día 94, alguien en el comité de crisis propuso una solución distinta: que el cuartel general actuara como coordinador central y exigiera confirmación de todos los refugios antes de dar cualquier operación por válida. Primero preguntaría a cada refugio "¿estás listo para comprometerte?" —fase 1— y solo cuando todos respondieran afirmativamente enviaría la orden definitiva de confirmar —fase 2—. Garantía total, en teoría.
El problema es que mientras cada refugio espera la confirmación final, sus recursos quedan bloqueados: nadie puede entrar ni salir hasta que el coordinador cierre el ciclo. Y si el cuartel general cae entre las dos fases —un corte de luz, un francotirador, un zombis en la salda del generador— todos los refugios se quedan congelados indefinidamente esperando una orden que nunca llega. Lo que era un punto de coordinación se convierte en un punto único de fallo. Además, no todos los refugios hablan el mismo protocolo de radio: exigir que todos lo soporten es una restricción operativa que en pleno apocalipsis nadie puede garantizar.
Esto de lo que hemos hablado es el protocolo de confirmación en dos fases (Two-Phase Commit, 2PC). En teoría resuelve el dilema de la doble escritura; en la práctica has convertido un punto de coordinación en un punto único de fallo, incrementas la latencia de cada operación y exiges que todos los sistemas soporten el protocolo. En sistemas con alta disponibilidad, el coste supera casi siempre al beneficio. El patrón Outbox con idempotencia en los consumidores cubre la gran mayoría de los casos con mucho menos complejidad operativa. Reserva 2PC para escenarios muy excepcionales donde el coste operativo sea asumible y la atomicidad sea estrictamente imprescindible.
Orden y concurrencia
Cuando docenas de grupos transmiten avisos de radio al mismo tiempo, los mensajes pueden llegar en orden distinto al que fueron enviados. Un aviso de salida que llega después del aviso de llegada puede hacer creer al sistema que el superviviente entró antes de salir.
En sistemas con alta concurrencia, es posible que un evento anterior llegue después de uno posterior. Incluir un número de versión o secuencia en los eventos del agregado permite a la Saga detectar y rechazar (o encolar) eventos desordenados. Para evitar que dos instancias paralelas de la misma Saga avancen el mismo estado simultáneamente, el registro de la Saga debe estar protegido con bloqueo pesimista o una restricción de unicidad en base de datos que impida que dos procesos modifiquen el mismo estado a la vez.
2. Un superviviente en el páramo: consistencia eventual entre agregados
En la segunda parte presentamos el SurvivorTransferService como solución para transferir un superviviente entre dos refugios. Volvamos a mirarlo con ojo crítico. De hecho, fue exactamente este servicio el que nos dio problemas la noche del día 94: con cuatro supervivientes moviéndose en paralelo hacia el Refugio 7, las escrituras se pisaron y dos transferencias quedaron en un estado inconsistente. El sistema creía que esos supervivientes seguían en el Refugio 3, que ya estaba sellado. Nadie supo dónde estaban durante horas.
// De la parte 2: modifica DOS agregados en el mismo flujo
export class SurvivorTransferService {
  public transfer(
    survivor: Survivor,
    fromShelter: Shelter,
    toShelter: Shelter
  ): void {
    if (survivor.isInfected()) throw new DomainError("...");
    if (!toShelter.hasCapacity()) throw new DomainError("...");
    if (survivor.isSpecialist() && fromShelter.wouldBeUnsafeWithout(survivor)) {
      throw new DomainError("...");
    }

    fromShelter.removeSurvivor(survivor.id);
    toShelter.admit(survivor);
    // Quien llama a esto guarda los dos refugios. Son dos agregados. Una transacción.
  }
}
El problema no es la lógica de negocio, que es correcta. El problema es el escenario a escala: imagina docenas de refugios enviando supervivientes al mismo refugio central bien abastecido. Cada transferencia bloquea simultáneamente dos filas en la base de datos: la del refugio de origen y la del refugio de destino. Con suficiente concurrencia, esto genera una avalancha de bloqueos en cascada que puede paralizar el sistema en el peor momento posible.
Además, viola la regla de oro de DDD: un agregado, una transacción. Los agregados definen fronteras de consistencia que, por diseño, deberían ser independientes entre sí.
La solución: dejar al superviviente caminar
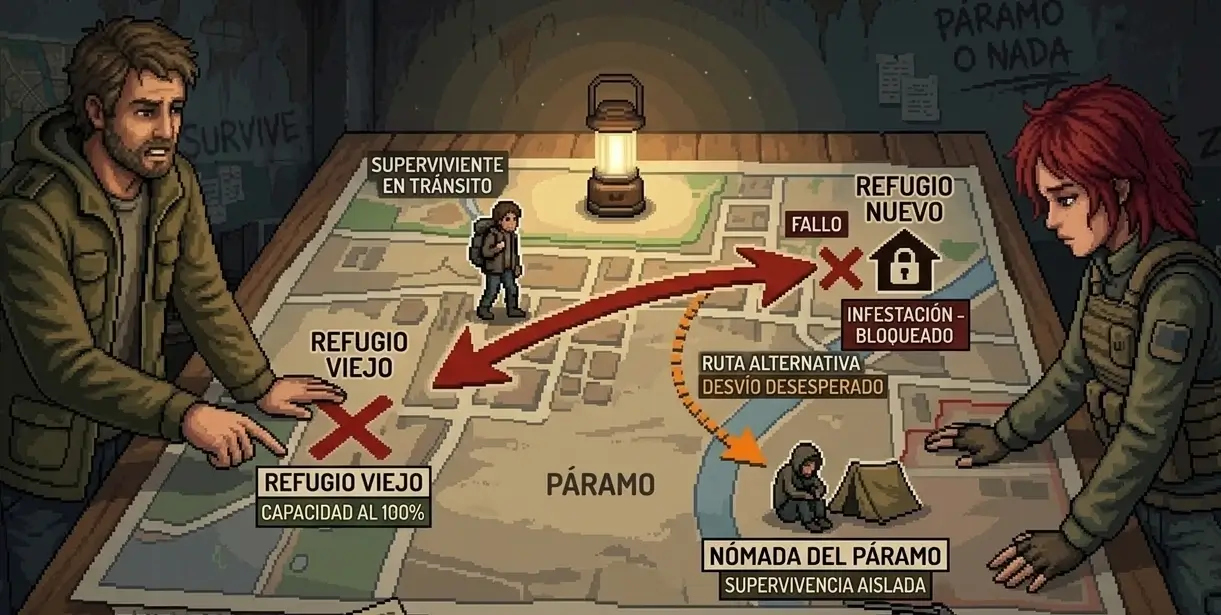
El equivalente físico de lo que queremos hacer es este: el refugio de origen abre sus puertas, el superviviente sale al páramo, las puertas se cierran y el guardia anota su salida. El refugio de destino no sabe nada todavía. Horas después, el superviviente llega y golpea la puerta. El refugio de destino decide entonces, con sus propias reglas actuales, si hay sitio.
Cada refugio solo bloquea su propia fila. Nunca los dos a la vez.
Paso 1: el comando inicial solo toca el refugio de origen.
// Nuevo método en Shelter: gestiona la salida, devuelve al superviviente
public transferOut(survivorId: string): Survivor {
  const survivor = this.survivors.find(s => s.id === survivorId);
  if (!survivor) {
    throw new DomainError(`Superviviente ${survivorId} no encontrado`);
  }
  if (survivor.isInfected()) {
    throw new DomainError("No se puede transferir a un superviviente infectado");
  }
  this.survivors = this.survivors.filter(s => s.id !== survivorId);
  this.currentCount--;
  return survivor;
}

// Handler: una sola transacción, un solo agregado
export class InitiateTransferHandler {
  async handle(cmd: InitiateTransferCommand): Promise<void> {
    await db.transaction(async (trx) => {
      const fromShelter = await this.shelterRepo.findById(cmd.fromShelterId, trx);

      // El refugio de origen aplica sus reglas y devuelve al superviviente
      const survivor = fromShelter.transferOut(cmd.survivorId);
      await this.shelterRepo.save(fromShelter, trx);

      // El superviviente está "en tránsito": lo serializamos en el evento
      await trx("outbox_events").insert({
        id: crypto.randomUUID(),
        event_type: "SurvivorTransferInitiated",
        payload: JSON.stringify({
          survivorId: cmd.survivorId,
          fromShelterId: cmd.fromShelterId,
          toShelterId: cmd.toShelterId,
          survivorSnapshot: survivor.toSnapshot()  // Más sobre esto en la sección 3
        }),
        created_at: new Date(),
        processed_at: null
      });
    });
    // La transacción termina aquí. El refugio de destino no sabe nada todavía.
  }
}
Paso 2: el refugio de destino reacciona de forma independiente cuando recibe el evento.
eventBus.on("SurvivorTransferInitiated", async (event) => {
  await db.transaction(async (trx) => {
    const toShelter = await shelterRepo.findById(event.toShelterId, trx);
    const survivor = Survivor.reconstitute(event.survivorSnapshot);

    try {
      // El destino aplica sus propias reglas en este instante
      toShelter.admit(survivor);
      await shelterRepo.save(toShelter, trx);

      await trx("outbox_events").insert({
        id: crypto.randomUUID(),
        event_type: "SurvivorTransferCompleted",
        payload: JSON.stringify({
          survivorId: event.survivorId,
          shelterId: event.toShelterId
        }),
        created_at: new Date(),
        processed_at: null
      });
    } catch (error) {
      // El destino no puede admitirlo: emitimos el rechazo
      await trx("outbox_events").insert({
        id: crypto.randomUUID(),
        event_type: "SurvivorAdmissionRejected",
        payload: JSON.stringify({
          survivorId: event.survivorId,
          fromShelterId: event.fromShelterId,
          toShelterId: event.toShelterId,
          survivorSnapshot: event.survivorSnapshot,
          reason: error.message
        }),
        created_at: new Date(),
        processed_at: null
      });
    }
  });
});
sequenceDiagram
    actor G as Guardia
    participant O as Refugio origen
    participant DB as Base de datos
    participant W as OutboxWorker
    participant D as Refugio destino

    G->>O: InitiateTransferCommand
    rect rgb(20, 40, 20)
        note over O,DB: Transacción 1 — solo el origen
        O->>O: transferOut(survivorId)
        O->>DB: save(refugioOrigen)
        O->>DB: outbox ← SurvivorTransferInitiated
    end

    W->>DB: lee eventos pendientes
    W->>D: publica SurvivorTransferInitiated

    alt El destino tiene capacidad
        rect rgb(20, 20, 40)
            note over D,DB: Transacción 2 — solo el destino
            D->>D: admit(survivor)
            D->>DB: save(refugioDestino)
            D->>DB: outbox ← SurvivorTransferCompleted
        end
    else El destino está lleno
        rect rgb(40, 20, 20)
            note over D,DB: Transacción 2 — compensación
            D->>DB: outbox ← SurvivorAdmissionRejected
        end
    end
El caso que no podemos ignorar: el nómada
La consistencia eventual abre una caja de Pandora que el diseño debe afrontar: ¿qué pasa si el superviviente camina hasta el refugio de destino y le dicen que no hay sitio? No es una pregunta teórica. Ocurre cuando una evacuación simultánea de otro refugio llenó el destino mientras el superviviente estaba en camino. El superviviente lleva horas caminando y la puerta no se abre.
El refugio de origen ya lo sacó de su inventario. Si intentamos simplemente devolverlo, se pondrá en peligro ya que hay zombis en el camino de vuelta. La compensación no siempre es posible, y el sistema tiene que modelar este estado de forma explícita.
eventBus.on("SurvivorAdmissionRejected", async (event) => {
  // Opción 1: redirigir a otro refugio con capacidad
  const alternative = await shelterRepo.findWithCapacity();
  if (alternative) {
    await outboxRepo.insert({
      event_type: "SurvivorTransferInitiated",
      payload: JSON.stringify({
        ...event,
        toShelterId: alternative.id
      })
    });
    return;
  }

  // Opción 2: no hay alternativa. El superviviente es un Nómada.
  // Este no es un estado de error: es un concepto de dominio legítimo.
  await nomadRegistry.register({
    survivorId: event.survivorId,
    survivorSnapshot: event.survivorSnapshot,
    lastKnownShelterId: event.fromShelterId,
    reason: event.reason,
    registeredAt: new Date()
  });

  await alertService.sendUrgentNotification(
    `Superviviente ${event.survivorId} sin destino: activar protocolo de rescate`
  );
});
El concepto de Nómada no es un error del sistema ni un estado de excepción: es una realidad del dominio que la consistencia eventual nos obliga a modelar. En un apocalipsis zombi, hay gente que se queda sin refugio. Ignorar ese estado en el código no hace que deje de ocurrir: solo hace que ocurra sin que nadie lo sepa.
Persistir el estado de la Saga
La Saga que coordina la evacuación sabe en todo momento qué supervivientes se han transferido y en qué fase está el proceso. Pero ¿qué pasa si el servidor cae a mitad de la evacuación? Sin persistencia, la Saga pierde ese contexto al reiniciarse y el sistema queda en un estado desconocido: algunos supervivientes ya están en el refugio B, otros siguen en A, y nadie sabe exactamente cuántos ni cuáles.
La solución es persistir el estado de la Saga en su propia tabla, dentro de la misma transacción que los cambios del agregado:
// Una fila por instancia de Saga en curso
// saga_id | saga_type | state (JSON) | current_step | started_at | updated_at

export class EvacuationSaga {
  private survivorsTransferred: string[] = [];
  private currentStep: "initiating" | "transferring" | "completing" | "compensating" = "initiating";

  public toState(): object {
    return {
      survivorsTransferred: this.survivorsTransferred,
      currentStep: this.currentStep
    };
  }

  public static reconstitute(savedState: Record<string, unknown>): EvacuationSaga {
    const saga = new EvacuationSaga();
    saga.survivorsTransferred = savedState["survivorsTransferred"] as string[];
    saga.currentStep = savedState["currentStep"] as typeof saga.currentStep;
    return saga;
  }
}
Si el servidor cae mientras los supervivientes están en camino, la Saga sabe exactamente por dónde se quedó al reiniciarse: quiénes ya cruzaron, quiénes no, y cuál es el siguiente paso (o la compensación a ejecutar). Esto es lo que convierte a las Sagas en el mecanismo resiliente para operaciones largas: no la lógica en sí, sino el hecho de que esa lógica sobrevive a los reinicios.
El patrón Saga y la gestión de la consistencia eventual en microservicios están tratados en detalle en Microservices Patterns de Chris Richardson.
3. El patrón Snapshot: persistir sin comprometer la pureza
Hay un tercer problema que la noche del día 94 no provocó, pero que habría aparecido tarde o temprano: ¿cómo guarda y recupera el repositorio el estado interno de un agregado sin romper su encapsulación?
En la segunda parte mostramos el repositorio de PostgreSQL así:
export class PostgreSQLShelterRepository implements ShelterRepository {
  async findById(id: string): Promise<Shelter | null> {
    const row = await db.query("SELECT * FROM shelters WHERE id = ?", [id]);
    if (!row) return null;
    return this.mapToAggregate(row); // ← ¿Cómo funciona este método?
  }
}
Y lo dejamos ahí. Ese mapToAggregate esconde exactamente el problema del que ahora hay que hablar.
El muro: ¿cómo accede el repositorio al estado privado?
Los arrays survivors y supplies del refugio son privados. No tienen setters. El diseño es correcto: nadie debería poder modificarlos desde fuera sin pasar por los métodos de negocio.
Pero el repositorio necesita leer ese estado para guardarlo, y reconstituirlo para cargarlo. Sin una solución explícita, los equipos acaban haciendo una de estas dos cosas:
// ❌ MAL: Decoradores del ORM directamente en el dominio
class Shelter {
  @Column()
  public id: string;

  @OneToMany(() => Survivor)
  public survivors: Survivor[];  // ← privado... pero ahora con decorador de TypeORM
}

// ❌ MAL: Reflexión para saltarse la privacidad
const shelter = new Shelter(row.id, row.capacity);
(shelter as any)["survivors"] = survivors.map(mapRow);
Ambas opciones destruyen lo que estábamos protegiendo. La primera acopla el dominio al ORM: si cambias de TypeORM a Prisma, o a PostgreSQL, o a un cuaderno, tienes que tocar tus clases de negocio más críticas. La segunda usa (shelter as any) para saltarse TypeScript a la fuerza, que es exactamente lo mismo pero más honesto sobre lo que está haciendo.
La solución: el patrón Snapshot
La idea es que el propio agregado expone una representación plana de su estado, exclusivamente para que la infraestructura pueda trabajar con él. Un objeto sin comportamiento, sin reglas de negocio, solo datos:
// Interfaz del snapshot: solo datos, sin comportamiento
export interface ShelterSnapshot {
  id: string;
  capacity: number;
  currentCount: number;
  survivors: Array<{ id: string; name: string; health: number }>;
  supplies: Array<{ name: string; amount: number }>;
}

export interface SurvivorSnapshot {
  id: string;
  name: string;
  health: number;
}
El agregado añade dos métodos: uno para extraer su estado y otro para reconstituirse a partir de un snapshot.
export class Shelter {
  private survivors: Survivor[] = [];
  private supplies: Supply[] = [];
  private currentCount = 0;

  constructor(
    public readonly id: string,
    public readonly capacity: number
  ) {}

  // ── Métodos de negocio existentes ───────────────────────────────────────────

  public admit(s: Survivor): void {
    if (this.currentCount + 1 > this.capacity) {
      throw new DomainError("Refugio lleno: no podemos admitir más supervivientes");
    }
    this.survivors.push(s);
    this.currentCount++;
  }

  // ... resto de métodos de negocio

  // ── Persistencia ────────────────────────────────────────────────────────────

  /**
   * Devuelve el estado actual como un objeto plano.
   * Solo debe usarlo el repositorio para persistir.
   */
  public toSnapshot(): ShelterSnapshot {
    return {
      id: this.id,
      capacity: this.capacity,
      currentCount: this.currentCount,
      survivors: this.survivors.map(s => s.toSnapshot()),
      supplies: this.supplies.map(s => ({ name: s.name, amount: s.amount }))
    };
  }

  /**
   * Reconstituye un Shelter a partir de un snapshot guardado en base de datos.
   * NO aplica las invariantes de negocio: está cargando un hecho histórico, no procesando un nuevo comando.
   */
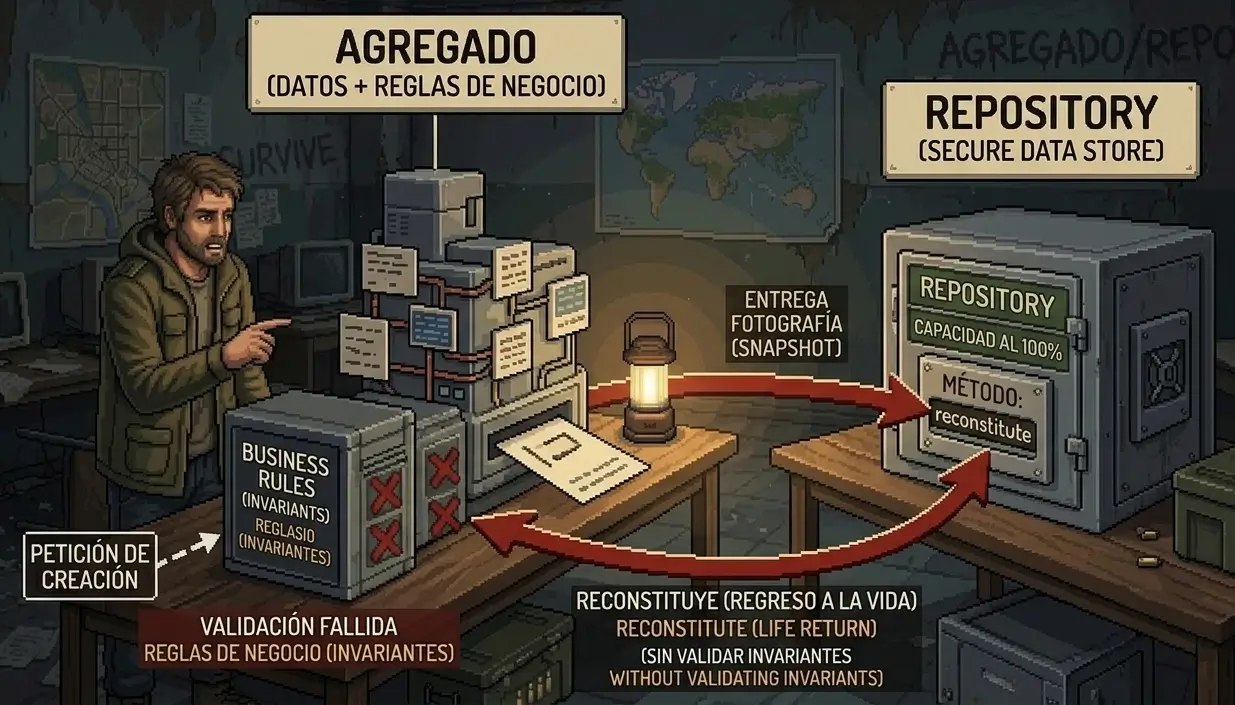
  public static reconstitute(snapshot: ShelterSnapshot): Shelter {
    const shelter = new Shelter(snapshot.id, snapshot.capacity);
    shelter.currentCount = snapshot.currentCount;
    shelter.survivors = snapshot.survivors.map(s => Survivor.reconstitute(s));
    shelter.supplies = snapshot.supplies.map(s => new Supply(s.name, s.amount));
    return shelter;
  }
}

export class Survivor {
  constructor(
    public readonly id: string,
    public name: string,
    public health: number
  ) {}

  public toSnapshot(): SurvivorSnapshot {
    return { id: this.id, name: this.name, health: this.health };
  }

  public static reconstitute(snapshot: SurvivorSnapshot): Survivor {
    return new Survivor(snapshot.id, snapshot.name, snapshot.health);
  }
}
Por qué reconstitute se salta las invariantes: la trampa del tiempo
Esta es la lección más profunda de esta sección, y conviene dejarla clara antes de seguir: hay una diferencia fundamental entre actuar en el presente y leer el pasado.
Imagina los expedientes sellados en el archivo histórico del búnker. En la entrada del 15 de septiembre pone: "admitidos 100 supervivientes, refugio al límite". Cuando el guardia abre esa carpeta hoy, no comprueba si el refugio tiene oxígeno suficiente para 100 personas. ¿Por qué lo haría? Ese hecho ya ocurrió, ya fue válido en su momento. Consultar ese expediente no activa ninguna regla del presente; solo devuelve la memoria de lo que fue.
reconstitute funciona exactamente así. No procesa un nuevo comando: reconstruye un estado que ya existió y que fue correcto cuando se guardó. Las invariantes de negocio se aplican a los comandos nuevos, no a la historia.
Imagina que en el día 40, con la información que había disponible, la regla de negocio decía que la capacidad máxima de un refugio era de 100 personas. El refugio se llenó con 100 supervivientes y ese estado se guardó en base de datos.
En el día 80, el colapso del sistema de ventilación del sector norte obligó a reducir la capacidad máxima a 50 personas y a actualizar el código en consecuencia.
Si el repositorio intentara reconstruir el refugio pasando los 100 supervivientes uno a uno por el método admit(), el sistema lanzaría una excepción en el superviviente número 51 y colapsaría. No podrías ni cargar el sistema para ver quién está dentro.
// ❌ Lo que NO debe hacer el repositorio:
const shelter = new Shelter(row.id, row.capacity); // capacity = 50 en el código actual
for (const survivorRow of survivorRows) {
  shelter.admit(new Survivor(survivorRow.id, ...)); // ← lanza error en el superviviente 51
}

// ✅ Lo que debe hacer:
const shelter = Shelter.reconstitute(snapshot); // carga directamente, sin validar
reconstitute no valida porque los datos vienen de tu propia base de datos: son hechos que ya ocurrieron y que fueron válidos en el momento en que se guardaron. No estás intentando meter 50 personas más hoy. Solo estás despertando el objeto para que recuerde cuánta gente tiene dentro.
Las invariantes aplican a los comandos nuevos, no a la historia. Si alguien intenta admitir un superviviente nuevo con la nueva regla de 50, admit() lo rechazará correctamente.
El repositorio actualizado
Con toSnapshot() y reconstitute() disponibles, el repositorio queda limpio y sin tocar el dominio:
export class PostgreSQLShelterRepository implements ShelterRepository {
  async findById(id: string): Promise<Shelter | null> {
    const row = await db("shelters").where({ id }).first();
    if (!row) return null;

    const survivors = await db("survivors").where({ shelter_id: id });
    const supplies = await db("supplies").where({ shelter_id: id });

    // Reconstituimos desde el snapshot: ni un ORM decorator, ni reflexión
    return Shelter.reconstitute({
      id: row.id,
      capacity: row.capacity,
      currentCount: row.current_count,
      survivors: survivors.map(s => ({ id: s.id, name: s.name, health: s.health })),
      supplies: supplies.map(s => ({ name: s.name, amount: s.amount }))
    });
  }

  async save(shelter: Shelter, trx?: Knex.Transaction): Promise<void> {
    const conn = trx ?? db;
    const snap = shelter.toSnapshot(); // Pedimos la foto al agregado

    await conn("shelters")
      .insert({ id: snap.id, capacity: snap.capacity, current_count: snap.currentCount })
      .onConflict("id").merge();

    // Sustituimos supervivientes: sencillo para este modelo
    await conn("survivors").where({ shelter_id: snap.id }).delete();
    if (snap.survivors.length > 0) {
      await conn("survivors").insert(
        snap.survivors.map(s => ({ ...s, shelter_id: snap.id }))
      );
    }

    await conn("supplies").where({ shelter_id: snap.id }).delete();
    if (snap.supplies.length > 0) {
      await conn("supplies").insert(
        snap.supplies.map(s => ({ ...s, shelter_id: snap.id }))
      );
    }
  }
}
El dominio no sabe nada de SQL. La infraestructura no sabe nada de reglas de negocio. La frontera está exactamente donde tiene que estar.
Este enfoque es una variante del patrón Data Mapper: en lugar de que un mapper externo deba conocer la estructura interna del agregado (violando la encapsulación), el propio agregado expone y consume su representación serializable mediante toSnapshot() y reconstitute(). El efecto es el mismo que si usaras DTOs explícitos de mapeo, pero sin acoplar la infraestructura al dominio. El dominio no sabe que existe una tabla SQL; la infraestructura no sabe qué reglas de negocio aplica el dominio.
El patrón Data Mapper, del que el Snapshot es una variante, está documentado en Patterns of Enterprise Application Architecture de Martin Fowler (el mismo libro que cubre el patrón Unit of Work mencionado antes).
4. Juntándolo todo: tres días en el refugio
Ha llegado el momento del simulacro completo. El código está disponible en GitHub con tres escenarios encadenados que cubren todo lo que hemos visto: admisión, transferencia y el caso del Nómada con concurrencia real.
Día 95 — María y Carlos llegan al Refugio 7
El Refugio 7 tiene capacidad para dos personas. El AdmitSurvivorHandler gestiona cada llegada por separado: carga el refugio desde el repositorio (usando reconstitute internamente), llama a shelter.admit() para que el dominio aplique sus reglas, persiste el nuevo estado (usando toSnapshot) y deja el evento SurvivorAdmitted en el outbox. El worker lo publica, Sanidad programa los chequeos y Logística actualiza las raciones. El refugio queda lleno.
AdmitSurvivorHandler → [Dominio] admit() → [Repo] toSnapshot → [Outbox] SurvivorAdmitted
OutboxWorker → Sanidad programa chequeo · Logística actualiza raciones
Día 96 — Carlos se traslada al Refugio 8
El Refugio 7 está lleno y Carlos necesita moverse. El InitiateTransferHandler solo toca el refugio de origen: saca a Carlos con transferOut(), guarda el estado actualizado y emite SurvivorTransferInitiated con el snapshot de Carlos serializado dentro. Una sola transacción, un solo agregado. El worker procesa el evento: el TransferEventHandlers carga el Refugio 8, aplica sus propias reglas y admite a Carlos. Refugio 8: lleno.
InitiateTransferHandler → [Dominio] transferOut() → [Outbox] SurvivorTransferInitiated
OutboxWorker → TransferEventHandlers → [Dominio] admit() en destino → SurvivorTransferCompleted
Día 97 — Pedro queda como Nómada
Pedro ocupa la plaza que dejó Carlos en el Refugio 7 —el refugio vuelve a estar lleno— y a continuación se inicia su traslado al Refugio 8. En ese momento el evento de Pedro está en el outbox, pendiente de procesar. Antes de que el worker lo gestione, Ana llega y ocupa la plaza que Pedro acaba de dejar libre en el Refugio 7. Cuando el worker finalmente procesa el traslado: el Refugio 8 está lleno, el Refugio 7 también. No hay alternativa. Pedro es un Nómada y su registro aparece en data/nomads/.
Este tercer escenario no es un caso inventado. Es exactamente lo que ocurre cuando la consistencia eventual y la concurrencia se cruzan: el sistema no puede garantizar que el destino siga disponible entre el momento en que se emite la orden de traslado y el momento en que se ejecuta. La solución no es añadir más bloqueos —eso nos devuelve al problema de la sección 2— sino modelar el Nómada como lo que es: una realidad del dominio con su propio estado, su propia alerta y su propio protocolo de rescate.
InitiateTransferHandler → [Outbox] SurvivorTransferInitiated (Pedro en tránsito)
[Concurrencia] Ana admitida → Refugio 7 lleno
OutboxWorker → Refugio 8 lleno → SurvivorAdmissionRejected
             → sin alternativa → Pedro registrado en data/nomads/
5. El refugio aguanta
Cuatro artículos después, el sistema ha evolucionado desde un user.status = 2 hasta un dominio que habla el idioma del apocalipsis, protege sus invariantes, coordina múltiples contextos sin acoplarse entre sí y persiste su estado sin comprometer su pureza.
Pero la lección más importante no es técnica. Es que DDD es, ante todo, una conversación continua con el dominio. Las herramientas —Bounded Contexts, Agregados, Repositorios, Outbox, Snapshots— son consecuencia de escuchar bien ese dominio y modelar lo que encuentras, incluyendo los estados incómodos como el superviviente nómada que el sistema cómodo preferiría ignorar.
Un dominio bien modelado no es el que no tiene casos límite. Es el que los nombra, los gestiona y los convierte en código que cualquiera del equipo puede leer sin abrir la documentación.
Mantened las puertas cerradas y el código limpio.
En la próxima y última entrega cerraremos la serie con un artículo de preguntas frecuentes, un checklist rápido de DDD para tener a mano y, quizás lo más importante, una guía honesta sobre cuándo usar DDD y cuándo no merece la pena. Porque no todo apocalipsis necesita un dominio rico.
Otros artículos de la serie
- Parte 1: Lenguaje ubicuo, bounded contexts, entidades, objetos de valor y agregados.
- Parte 2: Servicios de dominio, repositorios, capa de aplicación y eventos de dominio.
- Parte 3: Sagas, antipatrones y pruebas.
- F.A.Q.: Preguntas frecuentes.
Si te has quedado con ganas de más arquitectura, en Domain-Driven Design en un Apocalipsis Zombi lo cuento entero: entidades, agregados, contextos delimitados y un refugio que aguanta cuando el proyecto crece. En tapa blanda y Kindle, y gratis si tienes Kindle Unlimited.
Si quieres seguir por donde lo deja este artículo, en el libro tienes:
- Capítulo 7, «Repositorios»: el patrón Snapshot, CQRS y varias tecnologías de persistencia en un mismo contexto.
- Capítulo 9, «Eventos de dominio»: el patrón Outbox, la entrega de al menos una vez y los consumidores idempotentes.
- Capítulo 11, «Sagas»: qué hacer cuando no hay vuelta atrás, las Sagas atascadas y la coreografía.