
DDD en un apocalipsis zombi. Parte 2
28-02-2026
En la primera entrega de esta serie, sentamos las bases para integrar DDD en nuestro campamento. Establecimos un lenguaje ubicuo para acabar con la brecha entre lo que dice la líder del grupo y lo que escribe el desarrollador. Dividimos el sistema en Bounded Contexts para que Sanidad, Logística y Comando no se pisoteen entre sí. Aprendimos a distinguir entidades de objetos de valor y, por último, vimos cómo los agregados actúan como el guardián en la puerta del refugio: nadie modifica nada sin pasar por él. Te recomiendo leerlo antes, ya que reutilizaremos varias de las clases que definimos en él.
Todo eso era el interior. El núcleo. La lógica que mantiene el orden dentro de las paredes.
Pero un refugio necesita algo más para sobrevivir: operaciones que involucran a varios actores a la vez, mecanismos para comunicarse sin crear dependencias directas entre contextos, y una forma de persistir el estado sin que el dominio sepa si estás usando PostgreSQL o cuadernos viejunos. Alguien tiene que coordinar todo eso sin convertirse en la única persona que lo sabe todo y lo controla todo. Ya sabes cómo va esto de los apocalipsis zombi: quien sabe dónde están las llaves del generador, tiene acceso a los suministros críticos y entiende cómo funciona el sistema de ventilación es, invariablemente, la primera persona en convertirse en zombi en el peor momento posible. Y cuando eso pasa, el sistema entero se va a pique porque nadie más sabe cómo funciona.
En esta segunda parte vamos a ver exactamente eso: Servicios de Dominio, Repositories, la capa de Aplicación y Eventos de Dominio.
1. Servicios de Dominio (Domain Services)
A veces te encuentras con lógica de negocio que no encaja naturalmente en ninguna entidad ni objeto de valor. No es responsabilidad de un único agregado, sino que involucra conceptos de varios o simplemente representa una operación del dominio que no "pertenece" a nadie en particular.
¿Cuándo necesitas un Servicio de Dominio?
Pregúntate: ¿esta lógica es responsabilidad de un Superviviente? ¿De un Refugio? Si la respuesta es "no realmente, sino que es algo que pasa entre ellos" o "es un cálculo que usa información de varios sitios", entonces probablemente necesitas un Servicio de Dominio.
Un Servicio de Dominio contiene lógica de negocio pura: no realiza I/O (no accede a bases de datos ni a servicios externos), no mantiene estado interno y actúa sobre los parámetros que recibe para devolver resultados. No debe convertirse en un cajón de sastre con utilidades varias: su propósito es expresar reglas del dominio con nombre claro.
Ejemplo real: Cálculo de riesgo de contagio
Imagina que Luis, uno de nuestros exploradores, acaba de volver con el traje rasgado y cara de susto. Estuvo rodeado de infectados pero dice que mantuvo distancia... más o menos. El médico del refugio necesita calcular la probabilidad real de contagio según su proximidad a los zombis y el tiempo de exposición. Esta lógica:
- No es responsabilidad de Luis (el
Superviviente) (él no decide si se infecta o no, solo sufre las consecuencias). - No es responsabilidad del
Refugio(es un cálculo que puede ocurrir fuera también). - Es una regla del dominio que depende de factores físicos del apocalipsis zombi.
Con las condiciones anteriores, es cuando entraría en juego un Servicio de Dominio:
export class InfectionSpreadService {
  /**
   * Calcula la probabilidad de contagio según distancia y tiempo de exposición
   *
   * @param distanceMeters - Distancia al infectado en metros
   * @param exposureMinutes - Minutos de exposición
   * @returns Probabilidad entre 0 (sin riesgo) y 1 (contagio seguro)
   */
  public chanceOfInfection(
    distanceMeters: number,
    exposureMinutes: number
  ): number {
    // Regla del dominio: a menor distancia, mayor riesgo
    // A 0 metros = riesgo máximo (1.0)
    // A 20+ metros = sin riesgo (0.0)
    const base = Math.max(0, 1 - distanceMeters / 20);

    // Regla del dominio: el tiempo de exposición aumenta el riesgo
    // Menos de 60 minutos = riesgo proporcional al tiempo
    // 60+ minutos = factor máximo (1.0)
    const timeFactor = Math.min(1, exposureMinutes / 60);

    // Fórmula de contagio: combinamos distancia y tiempo
    // Base mínima del 50%, incrementa hasta 100% con el tiempo
    return Math.min(1, base * (0.5 + 0.5 * timeFactor));
  }
}

const infectionSpreadService = new InfectionSpreadService();

// Uso del servicio
const riesgo1 = infectionSpreadService.chanceOfInfection(5, 30);
console.log(riesgo1);
// ~0.59 (59% de probabilidad — hay que aislar a Luis)

const riesgo2 = infectionSpreadService.chanceOfInfection(15, 90);
console.log(riesgo2);
// ~0.25 (25% de probabilidad — más lejos, pero estuvo mucho tiempo)

const riesgo3 = infectionSpreadService.chanceOfInfection(1, 120);
console.log(riesgo3);
// ~0.95 (95% de probabilidad — Luis ya está prácticamente perdido)
¿Quién usa este servicio?
Este servicio es pura lógica de dominio, por lo que puede ser utilizado por:
- El agregado
Refugiocuando evalúa si activar una cuarentena automática. - Un proceso que simula interacciones entre supervivientes.
- La capa de aplicación cuando necesita decidir si un
SupervivienteExpuestodebe marcarse comoInfectado(hablaremos de esa capa en la sección 3).
Lo importante es que la lógica de negocio (cómo se calcula el contagio) está centralizada en un solo lugar con un nombre claro que refleja lo que hace. Si mañana los expertos en zombis dicen "en realidad, el contagio es más rápido a través del aire", solo modificas este servicio.
Cuando el servicio coordina múltiples agregados
El ejemplo anterior es un servicio "puro": solo hace cálculos con valores primitivos. Pero hay otra situación igualmente válida: lógica de negocio que involucra a varios agregados a la vez.
Imagina que necesitamos transferir un superviviente de un refugio a otro. La operación tiene reglas de negocio concretas:
- No se puede transferir a un superviviente infectado.
- El refugio de destino debe tener capacidad libre.
- Si el superviviente es un especialista (médico, ingeniero), el refugio de origen no puede quedar por debajo del mínimo de especialistas requerido.
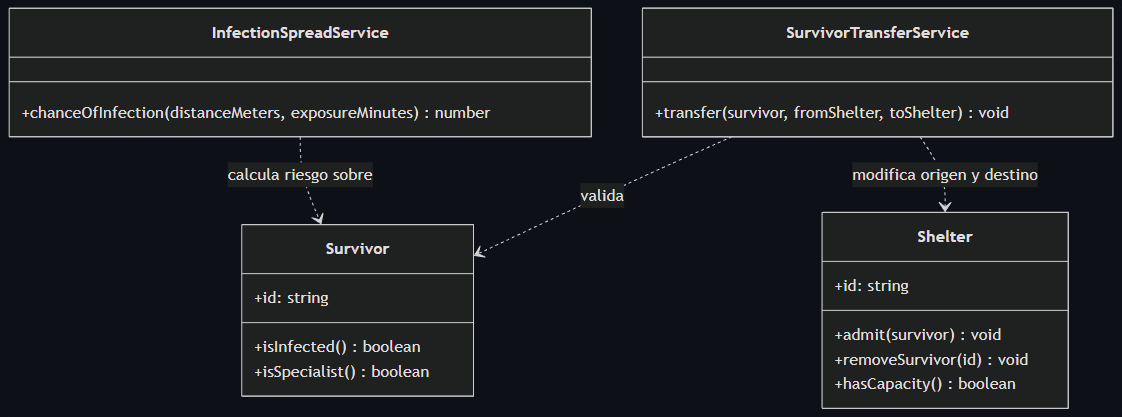
¿Dónde vive esta lógica? No en el refugio (Shelter) (no sabe nada del otro refugio) ni en los supervivientes (Survivor) (no decide a dónde va). Es una regla que cruza dos agregados: aquí entra el Servicio de Dominio.
export class SurvivorTransferService {
  /**
   * Valida y ejecuta la transferencia de un superviviente entre dos refugios,
   * aplicando todas las reglas de negocio del dominio.
   *
   * ⚠️ Los agregados deben llegar ya cargados: este servicio
   * no accede a repositorios ni a la base de datos.
   */
  public transfer(
    survivor: Survivor,
    fromShelter: Shelter,
    toShelter: Shelter
  ): void {
    // Regla de dominio: los infectados no se trasladan
    if (survivor.isInfected()) {
      throw new DomainError("No se puede transferir a un superviviente infectado");
    }

    // Regla de dominio: el destino debe tener hueco
    if (!toShelter.hasCapacity()) {
      throw new DomainError(`El refugio ${toShelter.id} no tiene capacidad`);
    }

    // Regla de dominio: un especialista no puede marcharse si deja al refugio
    // origen por debajo del mínimo de seguridad
    if (survivor.isSpecialist() && fromShelter.wouldBeUnsafeWithout(survivor)) {
      throw new DomainError(
        `${survivor.name} es especialista y su marcha dejaría el refugio en situación crítica`
      );
    }

    // Aplicar el traslado en los dos agregados
    fromShelter.removeSurvivor(survivor.id);
    toShelter.admit(survivor);
  }
}
La clave está en el comentario: los agregados llegan ya cargados. Este servicio no sabe ni le importa si los datos vienen de PostgreSQL, de una caché o de un archivador mugroso. Solo aplica las reglas del dominio sobre objetos del dominio.
Aunque SurvivorTransferService coordine el movimiento entre dos refugios, la última palabra la tienen los agregados. El servicio no hace shelter.count++ manualmente (lo cual rompería la encapsulación), sino que llama a toShelter.admit(). Es el agregado quien se asegura de que su invariante (por ejemplo: "nunca superar la capacidad máxima") se cumpla. Si el servicio intentara forzar algo ilegal, el agregado lanzaría un error y protegería la integridad del refugio.
2. Repositorios (Repositories)
Tenemos agregados con reglas de negocio bien protegidas y Servicios de Dominio que calculan cosas importantes. Pero falta una pieza crucial: ¿cómo guardamos y recuperamos estos agregados de la base de datos?
El problema de la persistencia
Piénsalo así: el médico del refugio sabe curar heridas, suturar mordeduras y detectar los primeros síntomas de infección zombi. Pero no tiene por qué saber dónde está el archivero con los historiales médicos ni cómo está organizado el almacén de material sanitario. Son dos responsabilidades completamente distintas. El día que cambiemos de sistema de archivo, el médico no tiene que aprender nada nuevo: sigue haciendo su trabajo.
Lo mismo ocurre con el dominio y la persistencia.
Si dejamos que nuestros agregados sepan cómo se guardan en base de datos, estaríamos mezclando dos responsabilidades completamente diferentes:
// ❌ HORRIBLE: El agregado sabe de SQL
class Shelter {
  public async save(): Promise<void> {
    await db.query(
      "UPDATE shelters SET capacity = ?, current_count = ? WHERE id = ?",
      [this.capacity, this.currentCount, this.id]
    );
    // Y ahora qué hacemos con los supervivientes, ¿otra tabla? ¿JSON?
  }
}
Esto rompe completamente la separación de responsabilidades. El dominio no debería saber si estás usando PostgreSQL, MongoDB, archivos JSON o palomas mensajeras para persistir datos.
La solución: Repositorios como abstracciones
Un Repositorio es una abstracción que se comporta como una colección en memoria, pero por debajo puede persistir los datos donde sea necesario. Es el intermediario perfecto entre el dominio puro y la infraestructura sucia. En DDD es siempre una interfaz (o clase abstracta). El dominio usa esta interfaz sin saber cómo está implementada:
// Esto va en la capa de DOMINIO
// Define QUÉ operaciones necesitamos, no CÓMO se hacen
export interface ShelterRepository {
  // Buscar un refugio por su ID
  findById(id: string): Promise<Shelter | null>;

  // Guardar un refugio (crear o actualizar)
  save(shelter: Shelter): Promise<void>;

  // Buscar refugios cercanos a unas coordenadas
  findAllNear(coords: Coordinates, radiusKm: number): Promise<Shelter[]>;

  // Buscar todos los refugios con capacidad disponible
  findWithCapacity(): Promise<Shelter[]>;
}
Fíjate en lo que NO está en esta interfaz:
- ❌ Nada de SQL, MongoDB, o cualquier tecnología específica
- ❌ Nada sobre tablas, colecciones, o estructura de datos
- ❌ Nada sobre conexiones, transacciones, o pooling
Solo operaciones del dominio expresadas en el lenguaje del negocio: "buscar refugio", "guardar refugio", "encontrar cercanos".
Las implementaciones van en Infraestructura
La implementación concreta (SQL, Mongo, memoria) se coloca en la capa de infraestructura, completamente separada del dominio:
// Esto va en la capa de INFRAESTRUCTURA
export class PostgreSQLShelterRepository implements ShelterRepository {
  async findById(id: string): Promise<Shelter | null> {
    const row = await db.query("SELECT * FROM shelters WHERE id = ?", [id]);
    if (!row) return null;

    // Aquí hacemos el mapeo de base de datos a agregado
    return this.mapToAggregate(row);
  }

  async save(shelter: Shelter): Promise<void> {
    // Aquí decidimos cómo persistir el agregado
    await db.query(
      "INSERT INTO shelters ... ON CONFLICT UPDATE ...",
      [shelter.id, shelter.capacity, /* etc */]
    );
  }

  // ... resto de métodos
}

// También podríamos tener una implementación en memoria para tests
export class InMemoryShelterRepository implements ShelterRepository {
  private shelters: Map<string, Shelter> = new Map();

  async findById(id: string): Promise<Shelter | null> {
    return this.shelters.get(id) || null;
  }

  async save(shelter: Shelter): Promise<void> {
    this.shelters.set(shelter.id, shelter);
  }

  // ... resto de métodos
}
Ventajas de este enfoque
- Dominio puro: Los agregados no saben nada de persistencia. Solo contienen lógica de negocio.
- Testeable: Puedes testear tu dominio usando un
InMemoryRepositorysin necesidad de levantar una base de datos real. - Flexible: Puedes cambiar de PostgreSQL a MongoDB sin tocar una sola línea del dominio. Solo cambias la implementación del Repositorio.
- Inversión de dependencias: El dominio define la interfaz que necesita. La infraestructura implementa esa interfaz. El dominio no depende de la infraestructura, es al revés (esto es la D de SOLID).
En resumen: los Repositorios son la frontera entre el mundo puro de las reglas de negocio y el mundo sucio de bases de datos, APIs y archivos. Y esa frontera está muy bien definida por una interfaz.
3. Aplicación: el director de orquesta
Ya tenemos agregados con reglas de negocio y repositorios que persisten datos. Pero falta algo: ¿quién coordina todo esto? ¿Quién recibe las peticiones del exterior y las traduce en operaciones del dominio?
Aquí entra la capa de aplicación. Su trabajo es orquestar, no contener lógica de negocio. Es el director de orquesta que dice "tú haz esto, luego tú aquello, y finalmente tú lo otro".
¿Qué hace la capa de aplicación?
La capa de aplicación es responsable de:
- Recibir comandos o peticiones del exterior (API REST, GraphQL, CLI, etc.)
- Validar permisos y autorización (¿puede este usuario hacer esto?)
- Cargar agregados desde los repositorios
- Invocar métodos del dominio (donde vive la lógica de negocio real)
- Guardar los cambios a través de los repositorios
- Publicar eventos de dominio para que otros se enteren (los veremos en la sección siguiente)
Pero lo más importante es también saber lo que NO hace la capa de aplicación:
- ❌ Contener reglas de negocio (eso es el dominio)
- ❌ Saber de detalles de persistencia (eso es infraestructura)
- ❌ Formatear respuestas para HTTP, GraphQL, etc. (eso es la capa de presentación)
Casos de uso y el patrón Command + Handler
Cada operación del sistema accesible desde el exterior es un caso de uso. Por ejemplo:
- Admitir un superviviente
- Transferir suministros
- Activar una cuarentena
La capa de aplicación se organiza en torno a ellos: un caso de uso por operación, con toda la orquestación necesaria y nada más.
Un patrón muy común en DDD para implementar esos casos de uso es usar Commands (comandos) y Handlers (manejadores). El Command describe la intención; el Handler es el caso de uso implementado:
// Un Command representa una INTENCIÓN
// "Quiero admitir a este superviviente en este refugio"
export class AdmitSurvivorCommand {
  constructor(
    public readonly shelterId: string,
    public readonly survivor: Survivor
  ) {}
}

// El Handler es quien EJECUTA la intención
export class AdmitSurvivorHandler {
  constructor(
    private shelterRepo: ShelterRepository,
    private eventBus: EventBus
  ) {}

  async handle(cmd: AdmitSurvivorCommand): Promise<void> {
    // 1. Cargar el agregado desde el repositorio
    const shelter = await this.shelterRepo.findById(cmd.shelterId);
    if (!shelter) {
      throw new Error("Refugio no encontrado");
    }

    // 2. Invocar método del dominio
    // AQUÍ es donde se validan las reglas de negocio (capacidad, etc.)
    shelter.admit(cmd.survivor);

    // 3. Persistir los cambios
    await this.shelterRepo.save(shelter);

    // 4. Publicar evento de dominio (lo explicaremos en la sección siguiente)
    // ...
  }
}
El flujo completo
Una de las grandes ventajas de organizar la capa de aplicación en casos de uso es que el mismo caso de uso puede ser invocado desde cualquier punto de entrada del sistema: una API REST, una interfaz de línea de comandos, un evento que llega de otro servicio o un proceso batch automático. La lógica de negocio y la orquestación no cambian en ningún caso; lo único que cambia es quién construye el Command y se lo pasa al Handler.
Veámoslo con un ejemplo. Aquí una API REST invoca el caso de uso que acabamos de definir:
// La API recibe una petición HTTP (capa de presentación)
app.post("/shelters/:id/admit", async (req, res) => {
  const command = new AdmitSurvivorCommand(
    req.params.id,
    new Survivor(req.body.survivorId, req.body.name, req.body.health)
  );

  // Construye el Command y delega en el caso de uso
  await admitSurvivorHandler.handle(command);

  res.status(200).json({ message: "Superviviente admitido" });
});
Fíjate en la separación de responsabilidades:
- API (Presentación): Recibe HTTP, construye el comando, devuelve HTTP
- Handler (Aplicación): Orquesta el caso de uso, sin lógica de negocio
- Shelter (Dominio): Valida la capacidad, aplica las reglas, protege invariantes
- Repository (Infraestructura): Persiste en la base de datos
Si mañana quisieras admitir supervivientes desde una CLI, desde un mensaje de otro sistema o desde un proceso nocturno automático, solo cambiaría cómo se construye el AdmitSurvivorCommand. El caso de uso —el AdmitSurvivorHandler— permanece intacto. Y el dominio ni se entera.
Servicio de Dominio vs. Capa de Aplicación
Aquí es donde mucha gente se confunde, porque un caso de uso de la capa de aplicación también "coordina" cosas. La diferencia es fundamental:
// SERVICIO DE DOMINIO
// Recibe objetos ya cargados, aplica reglas de negocio, sin I/O
transferService.transfer(survivor, shelterA, shelterB);

// HANDLER DE APLICACIÓN
// Carga objetos, llama al dominio, guarda cambios, despacha eventos
class TransferSurvivorHandler {
  public constructor(
    private survivorRepo: SurvivorRepository,
    private shelterRepo: ShelterRepository,
    private transferService: SurvivorTransferService
  ) { }

  async handle(cmd: TransferSurvivorCommand): Promise<void> {
    // 1. CARGAR (I/O: acceso a repositorios)
    const survivor = await this.survivorRepo.findById(cmd.survivorId);
    const fromShelter = await this.shelterRepo.findById(cmd.fromShelterId);
    const toShelter = await this.shelterRepo.findById(cmd.toShelterId);

    // 2. DOMINIO (sin I/O: solo lógica de negocio)
    this.transferService.transfer(survivor, fromShelter, toShelter);

    // 3. GUARDAR (I/O: acceso a repositorios)
    await this.shelterRepo.save(fromShelter);
    await this.shelterRepo.save(toShelter);
    await this.survivorRepo.save(survivor);
  }
}
Con la siguiente tabla puedes hacerte una idea de las diferencias entre ambos servicios para evitar confusiones:
| Servicio de Dominio | Servicio de Aplicación | |
|---|---|---|
| ¿Qué hace? | Aplica reglas de negocio | Orquesta un caso de uso completo |
| ¿Con qué trabaja? | Objetos del dominio ya cargados | Repositorios, eventos, servicios externos |
| ¿Tiene I/O? | ❌ Nunca | ✅ Siempre |
| ¿Contiene lógica de negocio? | ✅ Sí | ❌ No (delega en el dominio) |
| ¿Sabe de conexiones externas? | ❌ Nunca | Indirectamente, a través de repositorios |
Dicho de otra manera: el Servicio de Dominio sabe qué reglas gobiernan una operación del negocio. El Servicio de Aplicación sabe cómo ejecutar ese caso de uso de principio a fin. El primero es lógica; el segundo, coordinación u orquestación.
Si en algún momento te preguntas "¿esto debería ser un Servicio de Dominio o un caso de uso?", busca la respuesta en el I/O: si el código necesita acceder a repositorios o a cualquier infraestructura externa, es Aplicación. Si solo opera sobre objetos del dominio que ya tienes en memoria, es Dominio.
4. Eventos de Dominio (Domain Events)
Los Eventos de Dominio representan hechos que ya han ocurrido en el pasado y que son importantes para el negocio. No son órdenes ni peticiones, son notificaciones de algo que pasó y que otras partes del sistema podrían querer saber.
¿Por qué son importantes?
Los eventos son la clave para desacoplar partes del sistema que no deberían conocerse directamente. Pensemos en nuestro apocalipsis:
Imagina que un zombi consigue colarse por una brecha en el perímetro. El centinela que lo detecta no puede salir corriendo a avisar al médico, luego al encargado de Logística y luego al mando, uno por uno. Para cuando terminase el recorrido, ya habría medio refugio infectado. En su lugar, toca la alarma. Con esa acción, reaccionará toda la gente que necesite hacerlo. El centinela no sabe ni le importa quién escucha la alarma: su trabajo es detectar y avisar, no coordinar. Eso son exactamente los Eventos de Dominio.
Como siempre, para hacer un poco más sencilla la explicación lo veremos con un ejemplo en código: piensa al admitir a alguien en el grupo de supervivientes del refugio, ¿qué debe pasar?
- El equipo de Logística necesita saber que hay una boca más que alimentar
- El equipo de Sanidad debe registrar al superviviente para hacer un chequeo médico
- El equipo de Comando actualiza el mapa de distribución de personal
Si hicieras esto directamente en el método admit() del refugio, tendrías algo así:
// ❌ MAL: El refugio conoce demasiados detalles
public admit(survivor: Survivor): void {
  this.survivors.push(survivor);
  this.logisticService.updateFoodConsumption(this.id);
  this.medicalService.scheduleCheckup(survivor.id);
  this.commandService.updateMap(this.id, this.currentCount);
}
Esto es terrible porque:
- El
Refugioahora depende de 3 servicios que no son su responsabilidad - Si mañana quieres que algo más reaccione a la admisión, tienes que modificar el
Refugio - Estás acoplando contextos que deberían estar separados
La solución: Eventos de Dominio
En lugar de llamar directamente a todos esos servicios, el Handler —que ya conocemos de la sección anterior— publica un evento después de guardar el agregado. Quien esté interesado en ese evento, que reaccione.
Primero definimos los eventos como tipos con nombres en pasado (ya ocurrieron, son hechos consumados):
type DomainEvent =
  | {
      type: "SurvivorAdmitted";
      shelterId: string;
      survivorId: string;
      timestamp: string;
    }
  | {
      type: "SurvivorInfected";
      survivorId: string;
      infectedBy?: string; // Opcional: quién lo infectó
      timestamp: string;
    }
  | {
      type: "ShelterRestocked";
      shelterId: string;
      supplies: Array<{ name: string; amount: number }>;
      timestamp: string;
    }
  | {
      type: "QuarantineActivated";
      shelterId: string;
      reason: string;
      affectedCount: number;
      timestamp: string;
    };
El método admit() del refugio permanece limpio: solo aplica reglas y cambia estado, sin saber nada de lo que ocurre después:
public admit(s: Survivor): void {
  if (this.currentCount + 1 > this.capacity) {
    throw new Error("Refugio lleno");
  }
  this.survivors.push(s);
  this.currentCount++;
  // Nada más: el dominio aplica reglas y cambia estado
}
Y el Handler es quien publica el evento, siempre después de guardar. El Handler sabe qué operación acaba de ejecutar, por eso puede publicar el evento correcto:
class AdmitSurvivorHandler {
  async handle(cmd: AdmitSurvivorCommand): Promise<void> {
    const shelter = await this.shelterRepo.findById(cmd.shelterId);
    shelter.admit(cmd.survivor);
    await this.shelterRepo.save(shelter);

    // Si todo fue bien, notifica el evento.
    await this.eventBus.publish({
      type: "SurvivorAdmitted",
      shelterId: shelter.id,
      survivorId: cmd.survivor.id,
      timestamp: new Date().toISOString()
    });
  }
}
En sistemas robustos, se suele utilizar el patrón Outbox para garantizar la consistencia de que tras realizar todas las transacciones se publique correctamente el evento. Lo dejaremos fuera del alcance de este artículo. Podéis leer más sobre él en la cuarta parte de esta serie de artículos.
¿Quién escucha los eventos?
Diferentes partes del sistema pueden suscribirse a los eventos que les interesan:
// El servicio de Logística escucha admisiones
eventBus.on("SurvivorAdmitted", (event) => {
  logisticService.updateFoodConsumption(event.shelterId);
});

// El servicio de Sanidad también
eventBus.on("SurvivorAdmitted", (event) => {
  medicalService.scheduleCheckup(event.survivorId);
});

// Comando reacciona a infecciones para evaluar evacuaciones
eventBus.on("SurvivorInfected", (event) => {
  commandService.evaluateEvacuation(event.shelterId);
});

// Sanidad emite alertas ante brotes
eventBus.on("QuarantineActivated", (event) => {
  alertService.sendUrgentNotification(
    `¡Cuarentena activada en ${event.shelterId}! Motivo: ${event.reason}`
  );
});
Ventajas de usar eventos
- Desacoplamiento: El
Refugiono sabe quién reacciona a sus eventos, ni le importa. Solo publica lo que pasó. - Extensibilidad: Si mañana necesitas que otro servicio reaccione a
SurvivorAdmitted, solo añades un listener. No tocas el código delRefugio. - Auditoría: Los eventos son un registro de todo lo que ha pasado. Como cualquiera puede recibirlos, puedes guardarlos y tener un historial completo de eventos del apocalipsis.
- Procesos asíncronos: Los eventos permiten desencadenar procesos que no necesitan completarse inmediatamente (enviar alertas, actualizar dashboards, generar informes, etc.).
- Event Sourcing: Si además guardas todos los eventos de forma cronológica, estarías a un paso del Event Sourcing, que como diría Doc Brown, es la verdadera máquina del tiempo del dominio: te permite reconstruir todo lo que pasó, paso a paso, desde el día 0 del apocalipsis.
Los eventos son la columna vertebral de sistemas complejos bien diseñados. En DDD, son el pegamento que mantiene unidos los Bounded Contexts sin crear dependencias directas entre ellos.
Para terminar
Implementar estas capas puede parecer mucho trabajo extra cuando hay zombis golpeando la puerta, pero es lo que diferencia a un grupo de supervivientes organizado de una cena buffet para no-muertos. Gracias a que el equipo médico (Dominio) y la gente encargada de suministros (Infraestructura) hablan el mismo idioma y respetan sus fronteras, Luis está ahora en una zona de aislamiento segura en lugar de estar deambulando por el comedor buscando cerebros.
Hemos pasado de tener "código que funciona" a tener un sistema que refleja la realidad de nuestra supervivencia.
En el siguiente artículo, daremos el paso final: cómo evitar que todo vuele por los aires cuando varias cosas pasan a la vez (transacciones), qué errores no debes cometer nunca (antipatrones) y cómo probar que nuestro refugio es realmente impenetrable (testing). ¡Mantened las puertas cerradas y el código limpio!
Otros artículos de la serie
- Parte 1: Lenguaje ubicuo, bounded contexts, entidades, objetos de valor y agregados.
- Parte 3: Sagas, antipatrones y pruebas.
- Parte 4: Patrón Outbox, consistencia eventual entre agregados, el patrón Snapshot.
- F.A.Q.: Preguntas frecuentes.
Si te has quedado con ganas de más arquitectura, en Domain-Driven Design en un Apocalipsis Zombi lo cuento entero: entidades, agregados, contextos delimitados y un refugio que aguanta cuando el proyecto crece. En tapa blanda y Kindle, y gratis si tienes Kindle Unlimited.
Si quieres seguir por donde lo deja este artículo, en el libro tienes:
- Capítulo 9, «Eventos de dominio»: dónde nace el evento, eventos de dominio frente a eventos de integración, proyecciones y Event Sourcing.
- Capítulo 10, «Arquitectura hexagonal»: el dominio en el centro, los adaptadores y la estructura de carpetas.