
El Listo, El Bueno, El Feo y El Malo: cuando SRP se une a GBU
09-08-2026
En el artículo anterior había una pequeña limitación que no aprecié hasta empezar a usar el patrón más a menudo y en proyectos más complejos.
En este artículo vamos a resolver ese problema añadiendo un nuevo personaje al principio del patrón y veremos cómo aplicarlo en un caso práctico con Claude Code. Así que aquí comienza una nueva aventura en el Viejo Softweste.
El Listo entra en escena
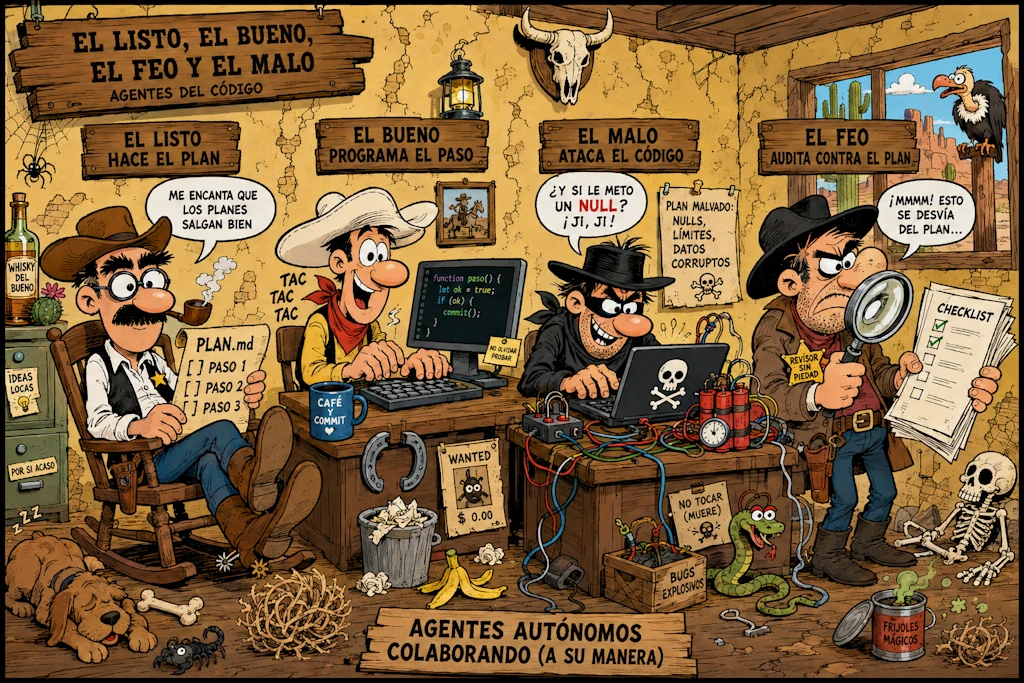
Si tienes cierta edad quizá recuerdes el mítico "¡Ya está el... listo que todo lo sabe!" (No decían listo exactamente, pero ya me entiendes) y si no la tienes pues hablo de esto.
Precisamente eso era lo que le faltaba al patrón, y no hablo de el g... ( que te veo venir), hablo de El Listo. Varias personas me hicisteis la misma observación tras el primer artículo: ¿por qué El Bueno tenía que hacer dos trabajos distintos, planificar y programar?
Y sí, con el patrón inicial nos habíamos saltado la S de los principios SOLID, algo que recordemos que no sólo aplica a código en bruto.
Así que en la oficina del sheriff faltaba una persona que se mece silenciosamente en su silla mientras observaba todo:
- 🥸 El Listo: Agente especializado en comprender el problema y convertirlo en un plan de implementación. No programa ni una sola línea de código, únicamente piensa y organiza el trabajo. Así que es el encargado de analizar la issue y dar forma al plan con el que el Bueno comenzará su trabajo.
La ventaja de esta evolución es que ahora cada agente tiene una única responsabilidad: El Listo piensa, El Bueno implementa, El Feo revisa y El Malo intenta romper el resultado.
Si seguimos la plantilla del artículo anterior tendremos dos cambios:
🥸 El Listo (El pensador y estratega)
Es ese tipo callado que nunca saca el revólver de primeras. Cuando llega un caso nuevo, se encierra en el despacho del sheriff con todos los informes, estudia la situación y sale con un plan claro para que El Bueno no improvise ni se meta en un callejón sin salida. Nunca escribe una línea de código: su trabajo termina cuando deja el camino perfectamente marcado.
- Entradas: La especificación funcional, la especificación técnica y el estado actual del proyecto.
- Salida: Un plan de ejecución incremental dividido en pequeños pasos.
Su prompt breve podría ser algo del estilo:
"Eres El Listo. Eres un Arquitecto de Software Senior especializado en transformar una especificación en un plan de implementación incremental. Lee la especificación funcional y técnica, analiza el estado actual del proyecto y genera un plan dividido en pequeños pasos. No escribas código. Tu única salida debe ser el plan."
🤠 El Bueno (El desarrollador optimista)
Ya viste que es el agente encargado de la implementación. Así que toma el siguiente paso del plan preparado por El Listo y lo implementa respetando la especificación funcional y técnica del proyecto. Ya no tiene que planificar qué hacer sólo seguir el camino marcado.
- Entradas: El plan, la especificación funcional y la especificación técnica.
- Salida: Código de producción, pruebas y cambios listos para revisión.
Su nuevo prompt breve será:
"Eres El Bueno. Un desarrollador Senior especializado en la arquitectura y las convenciones del proyecto. Lee el siguiente paso pendiente del PLAN y ejecútalo respetando la especificación funcional y técnica. No implementes pasos posteriores ni añadas funcionalidades no descritas."
Estos son prompts breves de ejemplo para que te hagas una idea. En la parte práctica del artículo verás prompts mucho más completos y adaptados a un flujo de trabajo real.
La ley del pueblo: el patrón, limpio
Antes de bajar al barro con ejemplos más complejos conviene revisar el flujo completo:
🥸 El Listo (una sola vez)
   analiza la tarea y el proyecto y escribe el plan:
   Tarea + Contexto + Pasos pequeños con checkboxes

Por cada paso pendiente del plan:

  🤠 El Bueno implementa el paso y deja los tests en verde
     │
  🌵 El Malo ataca la implementación: si la rompe, El Bueno
     │  corrige y El Malo verifica (con tope de rondas)
     │
  👺 El Feo la audita contra el plan: si hay desviaciones,
     │  El Bueno corrige y El Feo verifica (con tope de rondas)
     │
  Paso aprobado ──► siguiente paso
Y las reglas que este patrón debería seguir independientemente de su implementación serían las siguientes:
- Cada agente tiene una única responsabilidad. Uno piensa, uno construye, uno sabotea y uno audita. Nadie está pluriempleado.
- El plan es la única memoria compartida. El Listo es el único que lee la documentación del proyecto (
CLAUDE.md, README, acuerdos de equipo). Todo lo relevante lo sintetiza en la sección "Contexto" del plan, y el resto de agentes trabajan exclusivamente con el plan y el código. Con esto hay menos relecturas y menos gasto de tokens (que están a precio de lingote de oro). - El Feo y el Malo no saben cómo se implementó el código. En la primera versión, los tres personajes los interpretaba el mismo modelo en la misma sesión. La separación de prompts reducía la complacencia, pero el auditor "recordaba" lo que acababa de escribir el Bueno, con todo el sesgo que eso supone, ya que nadie en su sano juicio suele suspender su propio examen. El Malo y El Feo deben partir de cero y juzgar solo lo que hay en disco. Esta es, para mí, la regla más importante de todas.
- Primero se estabiliza el comportamiento, después se refactoriza. En el primer artículo el orden era Feo → Malo. Al usarlo descubrí que era mejor al revés: los tests adversarios de El Malo quedan incorporados a la suite, así que cuando El Feo pide retoques de estilo, esos tests ya montan guardia y El Bueno puede ajustar nombres y organización sin miedo. Con el orden antiguo, cada arreglo de estilo obligaba a plantearse un nuevo ataque.
- Veredictos con token exacto y bucles con tope. Los verificadores no narran su proceso ni enumeran lo que está bien: responden con el token exacto de aprobación o con el informe de lo que falla. Nada más. Exigir literalmente
SOBREVIVIO_AL_MALOyAPROBADO_POR_EL_FEOevita el clásico "apruebo, aunque sugeriría...", eso provocaría más gasto de inferencia al Sheriff y en muchos casos pararía la ejecución para preguntarte. Es por ello que además, cada verificador tiene un máximo de rondas por paso, puesto que si dejamos una condición de parada un tanto difusa, un LLM puede entrar en bucle (0,0 sin alcohol, perdón por el chiste).
Como has podido ver, tampoco hay cientos de reglas que aprender, sólo cinco sencillitas. Además, fíjate en que no se habla de con qué herramienta se ejecuta, cómo se lanza, qué modelo usa cada agente, quién hace commit ni cuándo, ni qué pasa exactamente cuando un verificador agota sus rondas. Todo eso dependerá de quién lo implemente y las necesidades que tenga.
Los papeles no piden actor
Otro elemento a tener en cuenta, es que en ningún sitio hemos indicado que todos los personajes tenga que interpretarlos la misma herramienta. Ni siquiera que todos sean una IA. Es decir, con el patrón se define la trama que seguirá cada papel en este western, pero será decisión tuya hacer el casting de los actores.
- 🥸 El Listo puede ser un humano. Un arquitecto o un tech lead que escribe el plan a mano, o que corrige el borrador que le propone la IA. Para tareas muy grandes puede ser un buen punto a tener en cuenta, ya que el plan es el momento más barato de toda la película para meter criterio humano. Y aunque el papel lo mantenga una IA, hay herramientas nacidas para ayudarle: los spec kits que están floreciendo alrededor del SDD existen justo para refinar especificaciones antes de que nadie escriba una línea de código.
- 🤠 El Bueno es el papel natural de un LLM, porque es donde más rinde su velocidad. Pero si lo interpreta un humano tampoco hay problema, ya que se convierte en el desarrollo de toda la vida con verificadores automáticos montando guardia.
- 🌵 El Malo tiene actores veteranos que no saben lo que es un LLM. Los fuzzers (AFL++, libFuzzer) llevan décadas rompiendo implementaciones con datos corruptos sin pedirle permiso a nadie. El property-based testing (Hypothesis en Python, fast-check en JavaScript, etcétera) genera sistemáticamente los nulls, vacíos y tamaños extremos de su batería. Y si quieres herramientas para el vector de concurrencia y carga, k6 o JMeter.
- 👺 El Feo se apellida Sonar en muchas empresas. El quality gate de SonarQube es un veredicto binario — passed o failed — que viene a ser un
APROBADO_POR_EL_FEO. En la misma agencia de casting también se presentan linters en modo estricto, Semgrep, ArchUnit (que audita reglas de arquitectura como si fueran tests)... y el actor clásico del papel: el revisor humano de la pull request de toda la vida. - ⭐ Hasta El Sheriff tiene doble. Un pipeline de CI (Jenkins, GitHub Actions y compañía) puede terminar orquestando todo el flujo según los resultados de cada personaje siempre y cuando sean en cierto modo deterministas.
Tras ver la lista, comprobarás que simplemente son los roles que siempre han existido: arquitecto, desarrollador, QA, revisor. Es decir, sólo le hemos dado un nombre a esta automatización, pero sigue siendo el reparto que todo equipo serio ya tenía.
Una de las ventajas de usar algunas herramientas para los papeles es que esos actores que no usan la IA son deterministas. Así que para una misma entrada, siempre darán un mismo veredicto, con lo que nos ahorramos alucinaciones y gasto de tokens. Además, un papel tampoco tiene por qué ser representado por un único actor: nada te impide un reparto donde El Malo esté compuesto por la Banda del Patio: un agente LLM, un fuzzer y una batería property-based todos trabajando en conjunto; o donde El Feo sea Sonar más un agente que interpreta aquello que esté por debajo de un warning. En esos casos, el veredicto del papel es el del conjunto, por lo que la salida seguirá siendo SOBREVIVIO_AL_MALO si nadie consigue romper nada.
Al final el patrón solo exige tres cosas de cada papel: que exista, que esté aislado de quien implementa y que entregue un veredicto claro.
Tras toda esta amplicación, pasaremos a ver mi reparto personal para trabajar con Claude Code. Todos los papeles son interpretados por agentes LLM, con un Sheriff orquestando. Por ello, es una implementación de referencia, montada para un flujo de trabajo en cuestión. Eres libre de copiarla si te encaja, pero tienes libertad absoluta para ajustar cada paso. Además, dejé los prompts escritos en español, así evito dejar cualquier parte compleja a una posible interpretación por un error a la hora de traducir al inglés. Como todo, escribe los tuyos en el idioma que prefieras.
Bienvenidos a Code City: cómo implementar el patrón GBU en Claude Code
Ahora sí, toca bajarse del caballo. El patrón vive en un puñado de ficheros markdown que puedes copiar a cualquier proyecto. Los tienes completos en el repositorio gbu.
tu-proyecto/
└── .claude/
    ├── agents/        # feo.md, malo.md  (los subagentes aislados)
    └── commands/      # gbu.md, listo.md, bueno.md, feo.md, malo.md
No hay nada que compilar ni configurar: Claude Code carga automáticamente los ficheros de commands/ como comandos slash y los de agents/ como subagentes. Y con esto el casting queda así:
| Personaje | Comando | Rol | Cómo se ejecuta |
|---|---|---|---|
| ⭐ El Sheriff | /gbu |
Orquesta el patrón completo | Agente principal |
| 🥸 El Listo | /listo |
Convierte la tarea en un plan incremental (PLAN.md) |
Rol adoptado por el Sheriff, solo al inicio |
| 🤠 El Bueno | /bueno |
Implementa el siguiente paso y deja los tests en verde | Rol adoptado por el Sheriff, con todo el contexto |
| 🌵 El Malo | /malo |
QA adversario: intenta romper la implementación | Subagente aislado, parte de cero |
| 👺 El Feo | /feo |
Auditor estricto: rechaza cualquier desviación | Subagente aislado, parte de cero |
El Listo y El Bueno son roles que el propio Sheriff interpreta con todo el contexto de la sesión: quien implementa necesita saberlo todo. Pero El Malo y El Feo son subagentes que arrancan sin ese contexto: no han visto la implementación ni la conversación que la produjo. Solo tienen el plan y el código en disco.
El artefacto central es PLAN.md, con cuatro secciones: Tarea (el comportamiento esperado), Contexto (las convenciones del proyecto que condicionan la implementación), Modo de ejecución (ahora vamos con ella) y Pasos (checkboxes). Cuando se marca un checkbox se entiende que ese paso ha sido terminado.
Añadí una sección Modo de ejecución que es algo de lo que no se habla en el patrón, porque dependiendo del caso, hay veces que puedo confiar en un commit automático (proyectos de prueba, mini POCs, etc), y otras en las que prefiero echar un vistazo, aunque sea rápido a todo lo generado antes de subirlo. Así que la primera vez que /gbu arranca un plan, el Sheriff te pregunta qué hacer al cerrar cada paso.
El flujo, fase a fase
FASE 0 (una sola vez)
  🥸 El Listo analiza el proyecto y los acuerdos del equipo
     y escribe PLAN.md: Tarea + Contexto + Pasos con checkboxes
  ⭐ El Sheriff te pregunta el Modo de ejecución y lo anota en el plan

Por cada paso pendiente del plan:

  FASE 1 — 🤠 El Bueno implementa el paso y deja la suite en verde
     │
     │   (atajo: si el diff solo trae comentarios, tests o formateo
     │    automático, el Sheriff omite las fases que no aportan)
     │
  FASE 2 — 🌵 El Malo (subagente) ataca los cambios: nulls, límites,
     │     datos corruptos, concurrencia... Sus tests quedan en la
     │     suite como regresión.
     │       ├─ SOBREVIVIO_AL_MALO ──► continúa
     │       ├─ informe de fallos ──► El Bueno corrige todo de una
     │       │    pasada y El Malo verifica (máx. 3 lanzamientos)
     │       └─ 3 lanzamientos sin sobrevivir ──► lo pendiente queda
     │            anotado como deuda técnica y el paso continúa
     │
  FASE 3 — 👺 El Feo (subagente) audita contra el plan y las convenciones
     │       ├─ APROBADO_POR_EL_FEO ──► continúa
     │       └─ Informe de Desviaciones ──► El Bueno corrige y El Feo
     │            verifica (máx. 3 lanzamientos)
     │
  Fin del paso — checkbox marcado en PLAN.md y lo que diga el
                 Modo de ejecución: commit, push o quedarse en staging

Cuando no quedan pasos: COMPLETADO CON ÉXITO
Cada ejecución de /gbu avanza el plan paso a paso, y cada paso solo se cierra cuando El Malo ha dicho exactamente SOBREVIVIO_AL_MALO (o su resistencia ha quedado anotada como deuda, que de eso hablamos luego) y después El Feo ha dicho exactamente APROBADO_POR_EL_FEO. Si El Feo rechaza el trabajo tres veces seguidas, el Sheriff no insiste a ciegas: se detiene y te pide ayuda.
Los flujos del día a día
Con las piezas en la mesa, veamos las partidas que se pueden jugar.
Primera ejecución. No existe plan, así que le pasas la tarea al comando:
claude
> /gbu Necesitamos una web que convierta unidades del SI a otras que no lo son...
El texto tras el comando llega al prompt mediante la variable $ARGUMENTS, que Claude Code sustituye automáticamente. Al no existir PLAN.md, el Sheriff adopta a El Listo, genera el plan, te pregunta el Modo de ejecución y encadena el primer ciclo Bueno → Malo → Feo. A partir de ahí El Listo desaparece de escena.
$ARGUMENTS admite cualquier forma de señalar la tarea:
- Texto libre:
/gbu Añade un modo oscuro a la web - Un fichero de especificación:
/gbu Implementa la especificación de specs/conversor.md— encaja directamente con el enfoque SDD del artículo Del caos del vibe coding al rigor de la arquitectura: la carpetaspecs/versionada es la entrada natural de El Listo. - Una issue:
/gbu Comienza con la historia de https://github.com/org/repo/issues/123— El Listo la leerá con las herramientas que tenga disponibles.
Y cuando el plan ya existe, los argumentos también sirven para dirigir al Sheriff: una ruta a otro fichero de plan, un paso concreto por el que empezar, o «solo un paso» para que ejecute uno y pare. Nada de esto es parte del patrón, básicamente es un ajuste para darle ergonomía al comando.
Ejecuciones siguientes
En este caso ya existe plan, así que basta un /gbu a secas: se comprobará el paso en el que se detuvo la ejecución, omitiendo la planificación y se atacará el primer checkbox sin marcar. Puedes parar y relanzar cuando quieras ya que al tener el plan en disco evitamos que el estado sea la propia conversación.
Variante prudente para tareas grandes
Te aconsejo ejecutar primero /listo <tarea> a solas, una vez que lo tenga revisa el plan como humano ya que es el momento más barato de toda la película para corregir el rumbo. Una vez que esté todo revisado puedes lanzar /gbu que verá que hay un plan y comenzará con el primer punto.
Las piezas sueltas
Tal y como se ha dejado el código, puedes lanzar cada personaje por separado: /bueno implementa el siguiente paso sin verificación, /malo lanza solo el ataque sobre los cambios actuales y /feo solo hace la auditoría. Es útil para reincorporar el patrón cuando están en mitad de una tarea que empezaste a mano.
Particularidades de esta implementación
La implementación arrastra unas cuantas decisiones propias que fueron cayendo al usarla a diario, cada una nacida de un problema concreto, no de un ataque de arquitectitis. Te las cuento por si te sirven y para que sepas exactamente qué tocar si no te encajan.
- El staging de git marca la frontera entre pasos: Lo aprobado se stagea por lo que el resto de cambios es el paso en curso. Así los verificadores nunca re-auditan trabajo ya validado: miran solo el diff sin stagear.
- Presupuesto de esfuerzo proporcional al cambio: Tras las primeras pruebas apareció un patrón algo problemático, y es que los verificadores desplegaban la caballería entera para un cambio de tres líneas. Un rol sin límites escala su esfuerzo a su propia ambición. Así que el Sheriff se encarga de "medir" las diferencias antes de lanzar a nadie y les dice el tamaño en el encargo.
- El Feo no tiene shell a propósito: Su frontmatter (el bloque de metadatados del agente) declara
tools: Read, Grep, Globy se acabó: no puede ejecutar tests, ni hacer build, ni ejecutar comandos de git. Y es que tampoco lo necesita ya que El Bueno y El Malo ya se encargaron de comprobar que el código funcione. Es por ello que quitarle la shell evita que se ponga a hacer cosas que no le tocan y acabe ensuciando su misión. Es por ello que el Sheriff le pasa el diff en un fichero y los números de tests, lint, build y tipos que El Bueno dejó apuntados. Además se ha decidido usar un modelo más rápido (model: sonneten su frontmatter) ya que no requiere tanta potencia como sí la necesitan El List, El Bueno y El Malo. - La patrulla de instantáneas: El Malo tiene prohibido tocar el código de producción: ataca escribiendo tests, no editando líneas. Pero ya sabemos que hay veces que un LLM alucina y se salta restricciones. Así que el Sheriff, como buen agente, controla que El Malo no infrinja las leyes guardando una instantánea del diff de producción antes de lanzarlo y la compara al terminar. Podríamos decir, que le deja calcular como abrir la caja fuerte, pero sin tocarla (es un Sheriff que está esperando a jubilarse y no quiere complicaciones).
- La deuda no se pierde: ¿Y si El Malo agota sus tres intentos y sigue encontrando fallos? En la implementación personalizada esto no bloquea, sino que lo que queda pendiente junto a sus observaciones (esos hallazgos que no bloquean porque el tipo de dominio los declara imposibles o porque corregirlos se sale del paso) se anota en un
TECHNICAL_DEBT.mdpara atacarlo a futuro, sus tests quedan marcados como omitidos (nunca borrados) con referencia a la anotación, y el paso continúa hacia la auditoría. La lógica consiste en que rechazo persistente de El Feo casi siempre es una especificación ambigua que solo tú puedes resolver, así que ahí el Sheriff sí se planta; pero los fallos crónicos de El Malo suelen ser casos límite por los que no merece la pena bloquear el plan entero. Esto lo puedes ajustar y hacer que El Malo también bloquee, total es un párrafo del prompt del Sheriff. - Informes agregados, verificaciones acotadas: El Malo y El Feo completan su pasada entera y entregan todos los hallazgos de una vez, por lo que indican una lista de corrección por iteración en lugar de parar al primer fallo. Cuando vuelven a entrar tras una corrección, solo verifican el informe anterior y lo que la corrección ha tocado, sin repetir la batería completa. Además, en el caso de que una corrección pedida por El Feo toque comportamiento, El Malo volverá cual villano con ansia de venganza para una única verificación acotada; lo que encuentre ahí se guardará como deuda en vez de reabrir el ciclo. Si dejásemos que El Malo hiciera su trabajo habitual, las correcciones sugeridas por El Feo podrían hacer que El Malo actuase indefinidamente.
- El test de regresión se verifica por mutación: Cada corrección de El Bueno debe quedar cubierta por un test que él mismo verifica rompiendo a mano la línea recién arreglada: si el test no cae, el test no vale. Restaura y a otra cosa. Con eso se dedican unos segundillos que ayudan a evitar el tener un test en verde que no vigile nada.
- El Listo tiene un modo revisión: El patrón dice que El Listo entra una vez y desaparece. Pero en la implementación se ha añadido una excepción en el caso de que
PLAN.mdexista pero no cumpla el contrato (le falta la tarea, el contexto o los pasos). Esto es para estar prevenidos antes planes escritos a mano que omitieran alguna información.
Los atajos de El Sheriff
Ya vimos que El Sheriff tenía ganas de jubilarse, así que hay veces que quiere evitar tanto papeleo, por ejemplo: si el paso solo cambia comentarios, ¿qué va a hacer El Malo? Por muy mal escrito que esté un comentario, no devuelve un error 500. Así que el Sheriff, antes de llamar a los verificadores, echa un vistazo a los cambios y decide si hay atajo:
- Si sólo hay comentarios o documentación: El Malo queda fuera ya que no hay comportamiento que romper. Y El Feo quedará fuera también, siempre y cuando los comentarios no documenten contratos públicos.
- Solo tests, sin código de producción: aquí también queda fuera El Malo puesto que no hay implementación nueva que atacar. Sin embargo, El Feo entra siempre puesto que un test que se ajuste para un asset que rompa el dominio es un disfraz para evitar complicaciones.
- Solo formateo automático: es decir, cuando tenemos la salida de un prettier o un linter dejamos fuera los dos. Ya que en principio son cambios en el estilo que no deberían tocar la semántica del código.
- Recursos puramente estéticos: como pueden ser los CSS, imágenes, etc: aquí el El Malo queda también fuera, no está para criticar paletas de colores. El Feo si entra porque si por ejemplo la especificación habla de modo oscuro, los CSS deben ser coherentes.
Lo principal es que según el diff si el atajo a seguir es evidente lo tomamos. Si la niebla no deja ver el fondo del camino se sigue el flujo completo.
Cuando las cosas se tuercen
Creo que no hay ningún western en el que se queden tiroteos. Por lo que aquí te dejo una lista con algunos de los desenlaces menos felices, indicando como podrías actuar en cada uno:
- El Malo no deja de encontrar fallos: tras el tercer lanzamiento, recuerda que lo pendiente se deja anotado en
TECHNICAL_DEBT.mdy el flujo sigue. Al cerrar el paso, deberías revisar esa deuda:- Si son fallos reales, decide qué debe pasar, escríbelo en el plan y reactiva los tests que quedaron omitidos.
- Si son casos que tu dominio declara como imposibles, déjalos anotados y duerme tranquilo.
- El Feo rechaza tres veces seguidas: casi siempre significa que la especificación es ambigua y El Bueno y El Feo la interpretan distinto. Aquí el Sheriff sí se detiene y pide ayuda. En este caso la solución es aclarar esa ambigüedad en la sección "Tarea" o en la sección "Contexto" y relanzar
/gbu. - La sesión se corta a mitad de un paso: el estado persistente es
PLAN.md+ git. El checkbox sin marcar te dice que el paso no terminó. Ahí puedes relanzar/gbuindicando que el paso X se quedó a medias. - El plan resulta estar mal a mitad de camino: en última instancia tu eres el jefe o la jefa del Sheriff. Edita el plan a mano pídele a
/listoque replanifique lo que queda. Recuerda que en el flujo ideal El Listo "solo entra una vez", pero en este caso el plan estaba mal. - Los pasos salen demasiado grandes: pídelo explícitamente en la tarea ("pasos que toquen menos de X ficheros") o edita el plan para especificar la atomicidad de cada paso. Un paso debe dejar el proyecto funcional, ya sea una funcionalidad completa o nuevas entidades en dominio que se puedan commitear de forma aislada.
En conclusión
Empezamos con tres agentes que se odiaban cordialmente y al final tenemos la oficina del Sheriff hasta los topes, por lo que pasas de hacer todo el trabajo, a ser un mero analista revisando el plan y decidiendo cuánto quieres delegar en cada cierre de paso.
El código con mi implementación específica para Claude Code lo tenéis en el repositorio GBU. Y si lo adaptas a tu herramienta favorita o descubres que algún personaje necesita mano dura, cuéntamelo en LinkedIn o Instagram: en el Viejo Softweste siempre hay sitio para un forastero más.
También recuerda que esto se puede aplicar no sólo a programación, cualquier tarea que delegues en un LLM puede derivarse a este patrón para que no tengas que dar un salto de fe cada vez que se complete un paso.
Espero que GBU te haya podido ayudar a mejorar la automatización en tus proyectos y dar un paso adelante en la confianza al derivar las tareas a los LLMs.
Todo esto está tomando forma de libro: Desarrollo con IA en un Apocalipsis Zombi, el tercero de la saga. Aún está en preparación; en su ficha tienes el índice y lo que ya se puede contar. Si quieres que te avisen cuando salga, sigue al autor en Amazon: el refugio no manda correos, pero Amazon sí.